Google Cloud Summit Paris 2018
La Visibilité à 100 %
· Paris, France
Avoir une visibilité complète de votre système et de ses applications semble être la seule façon d’éviter les problèmes tout en s’assurant une bonne résolution des pannes critiques. Mais comment identifier de potentiels angles morts? Comment s’assurer une observabilité totale? Avec un nombre croissant de projets et de services de monitoring en concurrence pour votre attention et votre business, comment concilier une observabilité totale avec un budget limité ?
Dans cette session, je décomposerai le concept de monitoring en cinq catégories clés qui vous assurent une couverture complète de votre système. J’expliquerai également pourquoi ces catégories sont importantes pour votre entreprise, comment chacune offre une perspective unique à vos systèmes et comment les combiner pour trouver et résoudre rapidement des problèmes de performance.
#GoogleCloudSummit @GoogleCloud_FR
La visibilité à 100 % Daniel Maher (@phrawzty) Datadog (@datadoghq)
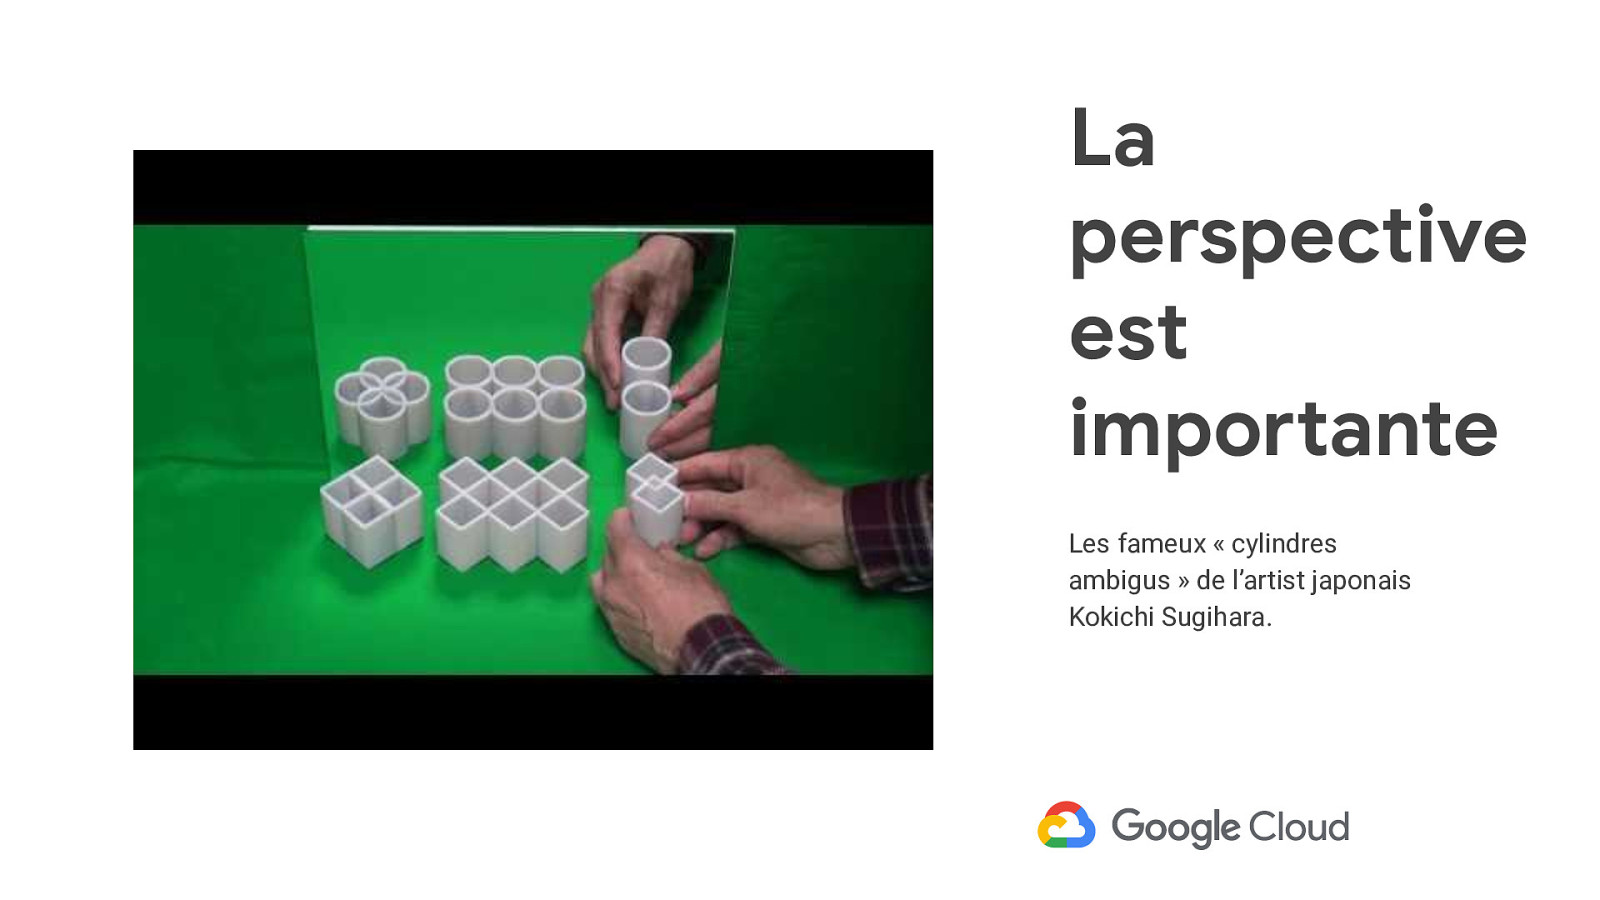
La perspective est importante Les fameux « cylindres ambigus » de l’artist japonais Kokichi Sugihara.
Daniel Maher Developer Relations chez Datadog @phrawzty
● Platforme « SaaS » de monitoring, métriques, APM, logs… ● Des millions de milliards de points de données par jour ● Bon citoyens libre logiciels ● Nous embauchons ! http://datadoghq.com/careers ● @datadoghq
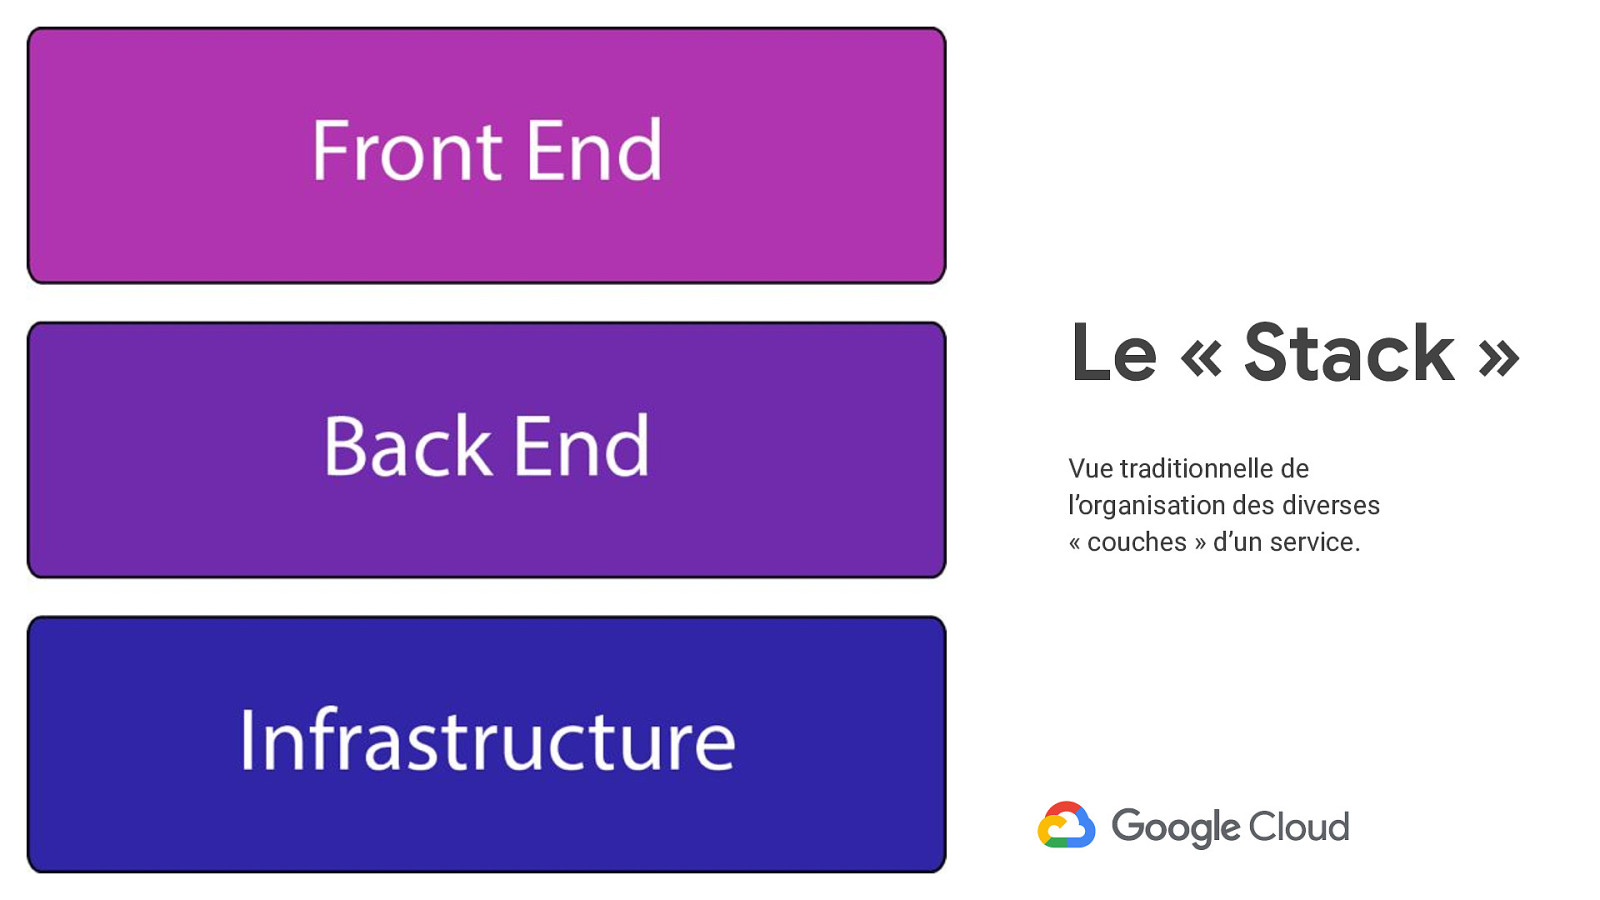
Le « Stack » Vue traditionnelle de l’organisation des diverses « couches » d’un service.
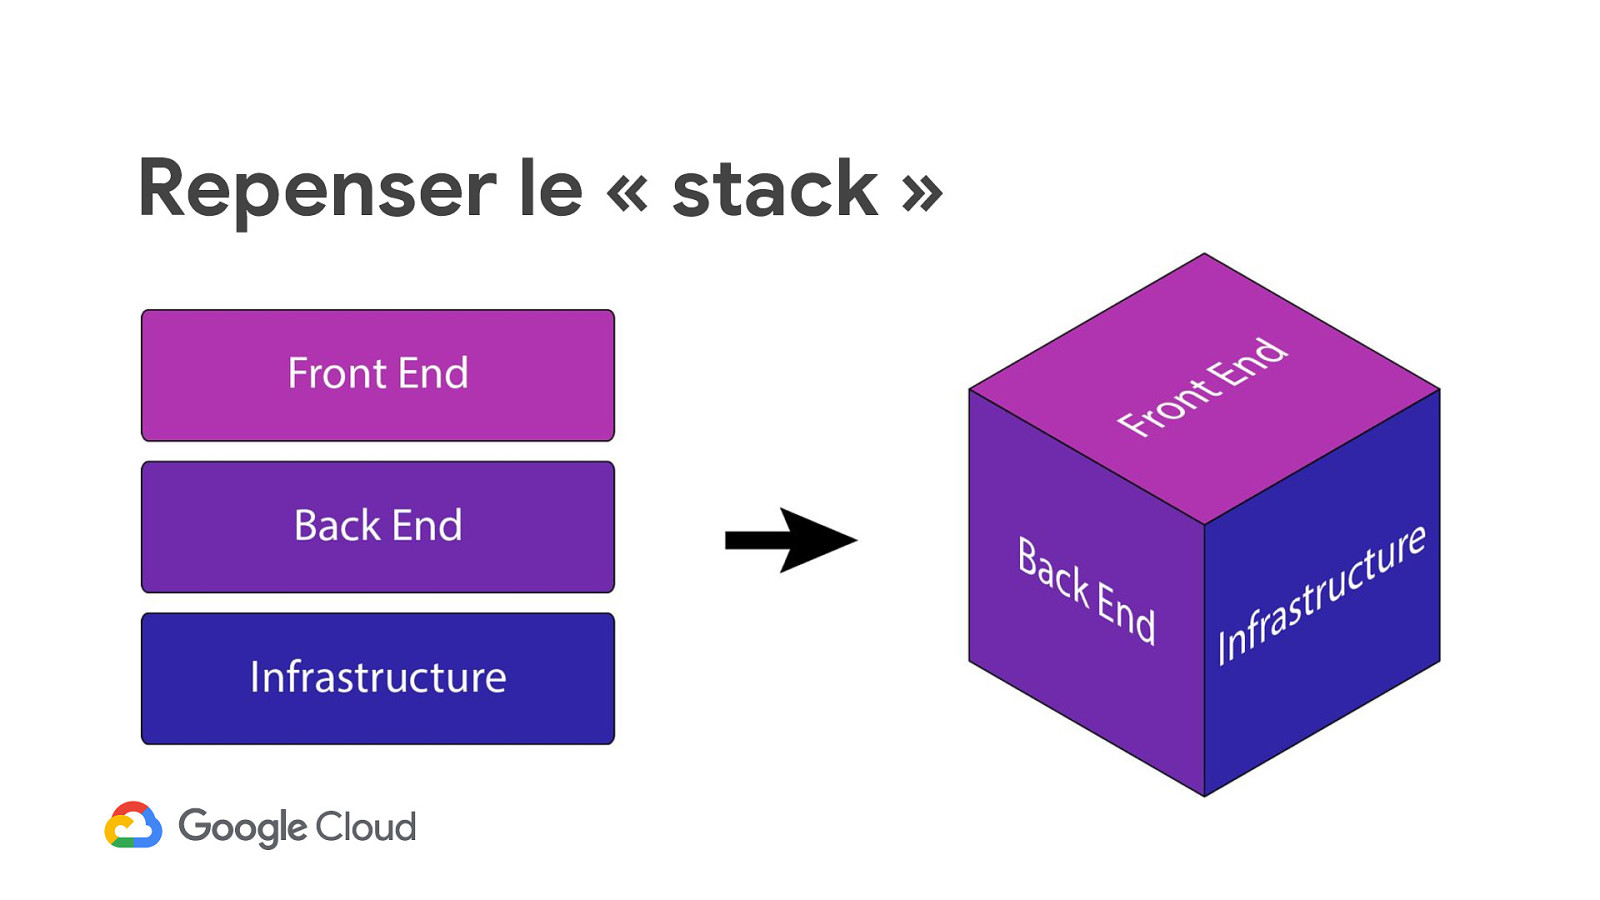
Repenser le « stack »
Récupérons quoi, alors ? Métriques Pratique afin de déterminer des tendances. Utile dans le contexte des alertes. Aide à identifier les « inconnues connues ».
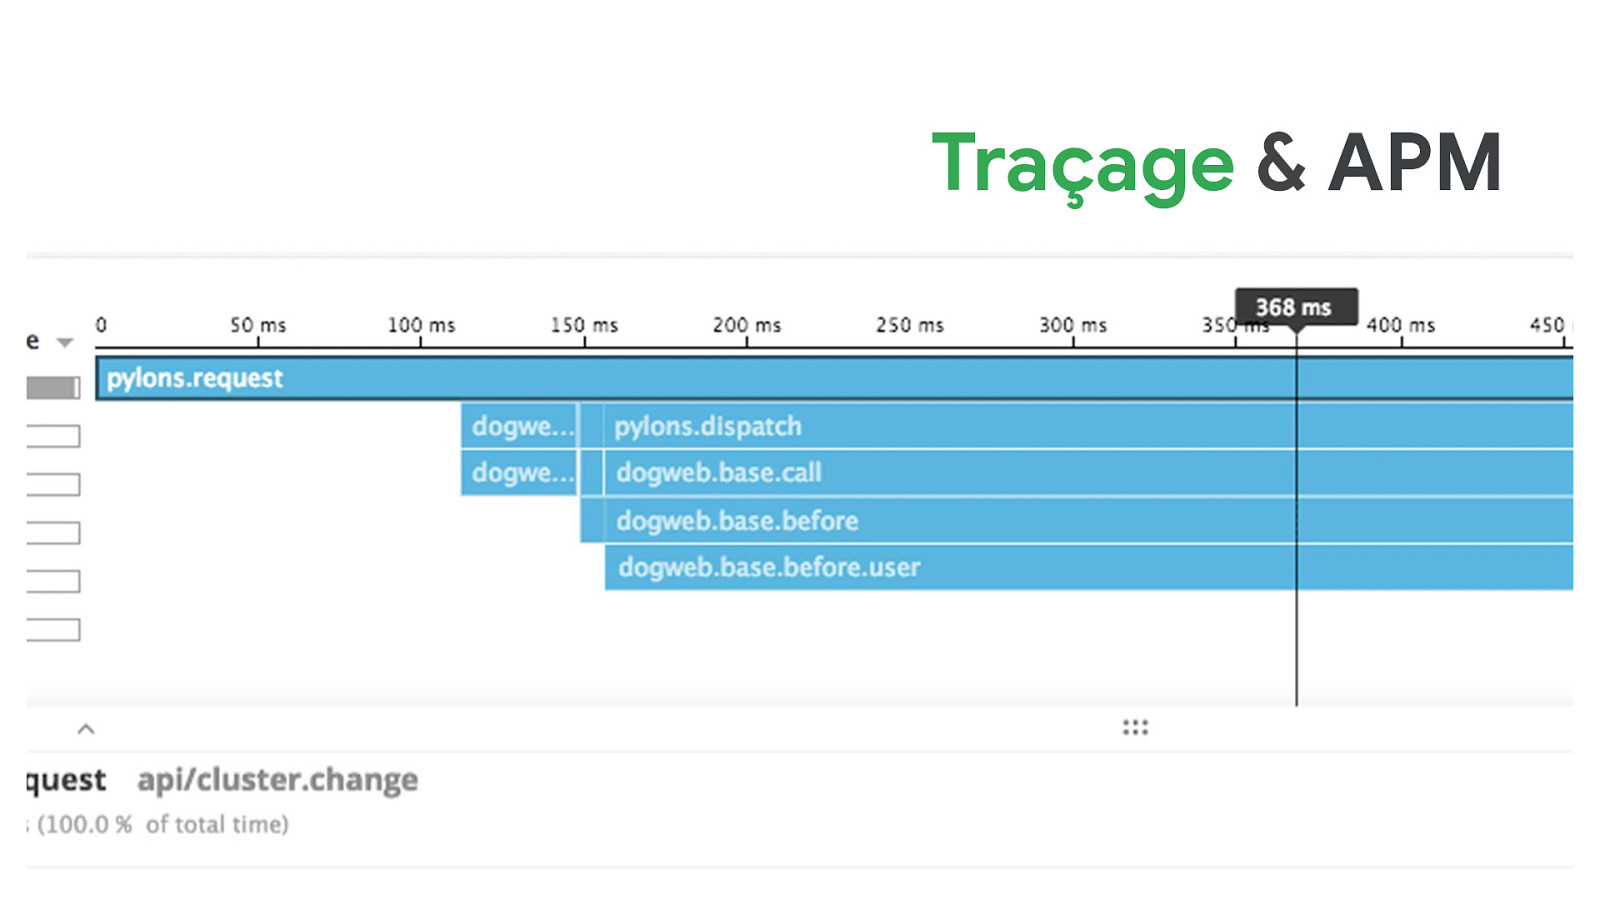
Récupérons quoi, alors ? Métriques Traçage Pratique afin de déterminer des tendances. « Tracing » en anglais. Utile dans le contexte des alertes. Aide à identifier les « inconnues connues ». Basé sur des requêtes. Suivre l’activité des requêtes à travers les appels fonction et service. Aide à comprendre le comportement du code.
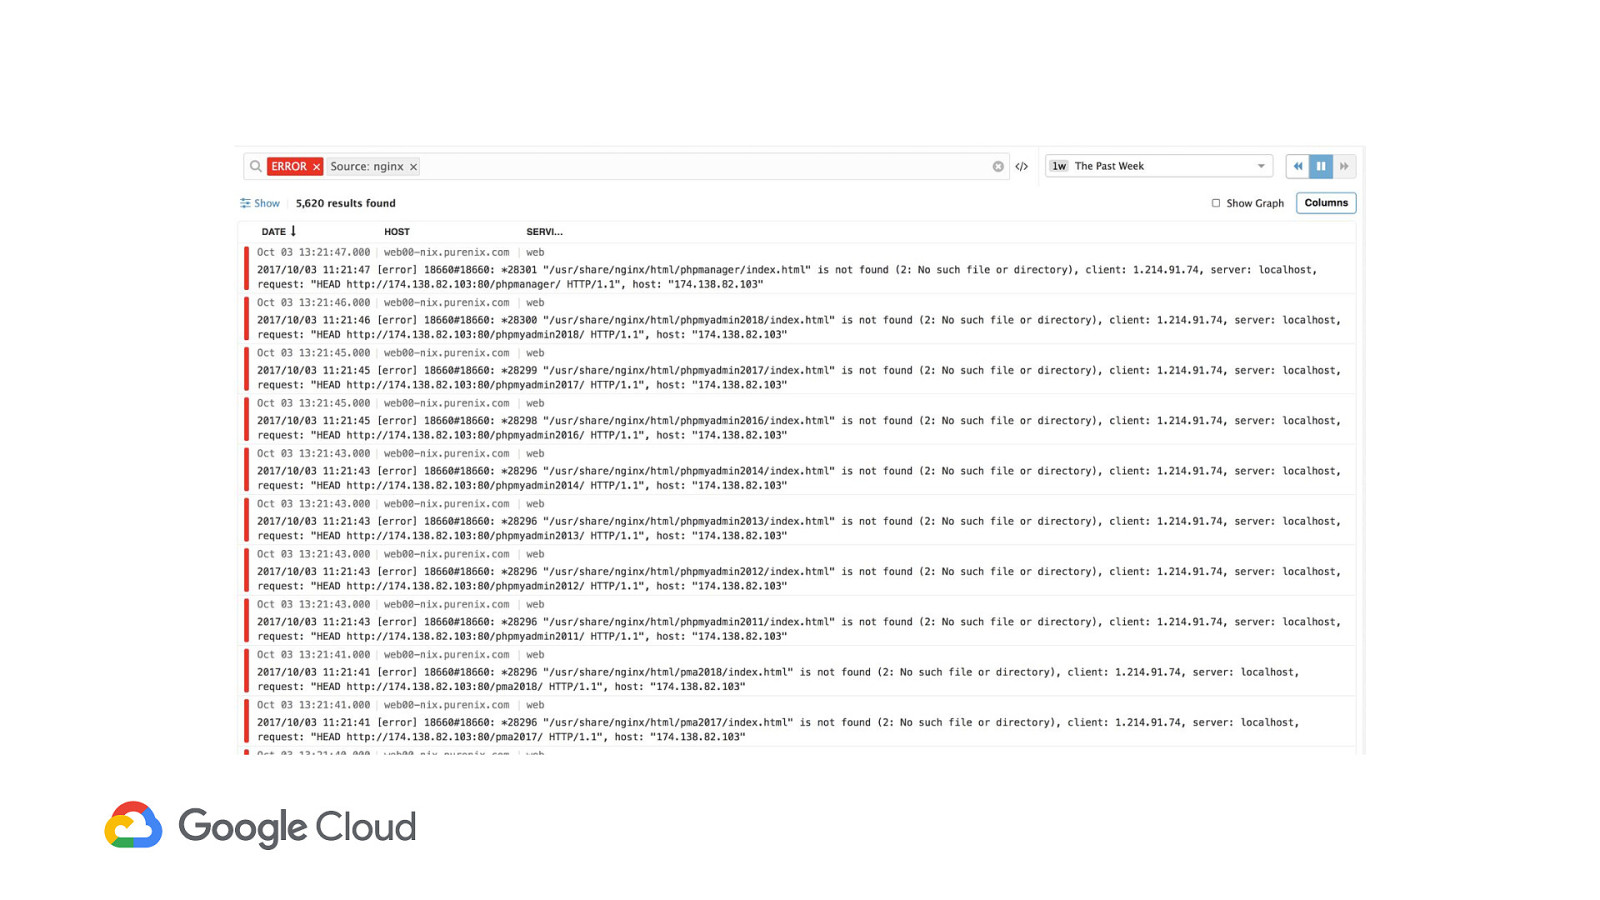
Récupérons quoi, alors ? Métriques Traçage Pratique afin de déterminer des tendances. « Tracing » en anglais. Utile dans le contexte des alertes. Aide à identifier les « inconnues connues ». Basé sur des requêtes. Suivre l’activité des requêtes à travers les appels fonction et service. Aide à comprendre le comportement de code. Journaux d’ évènements « Logs » en anglais. Basé sur des évènements, donc utile afin de poursuivre les petits détails. Verbose; structuré. Aide à identifier les « inconnues inconnues ».
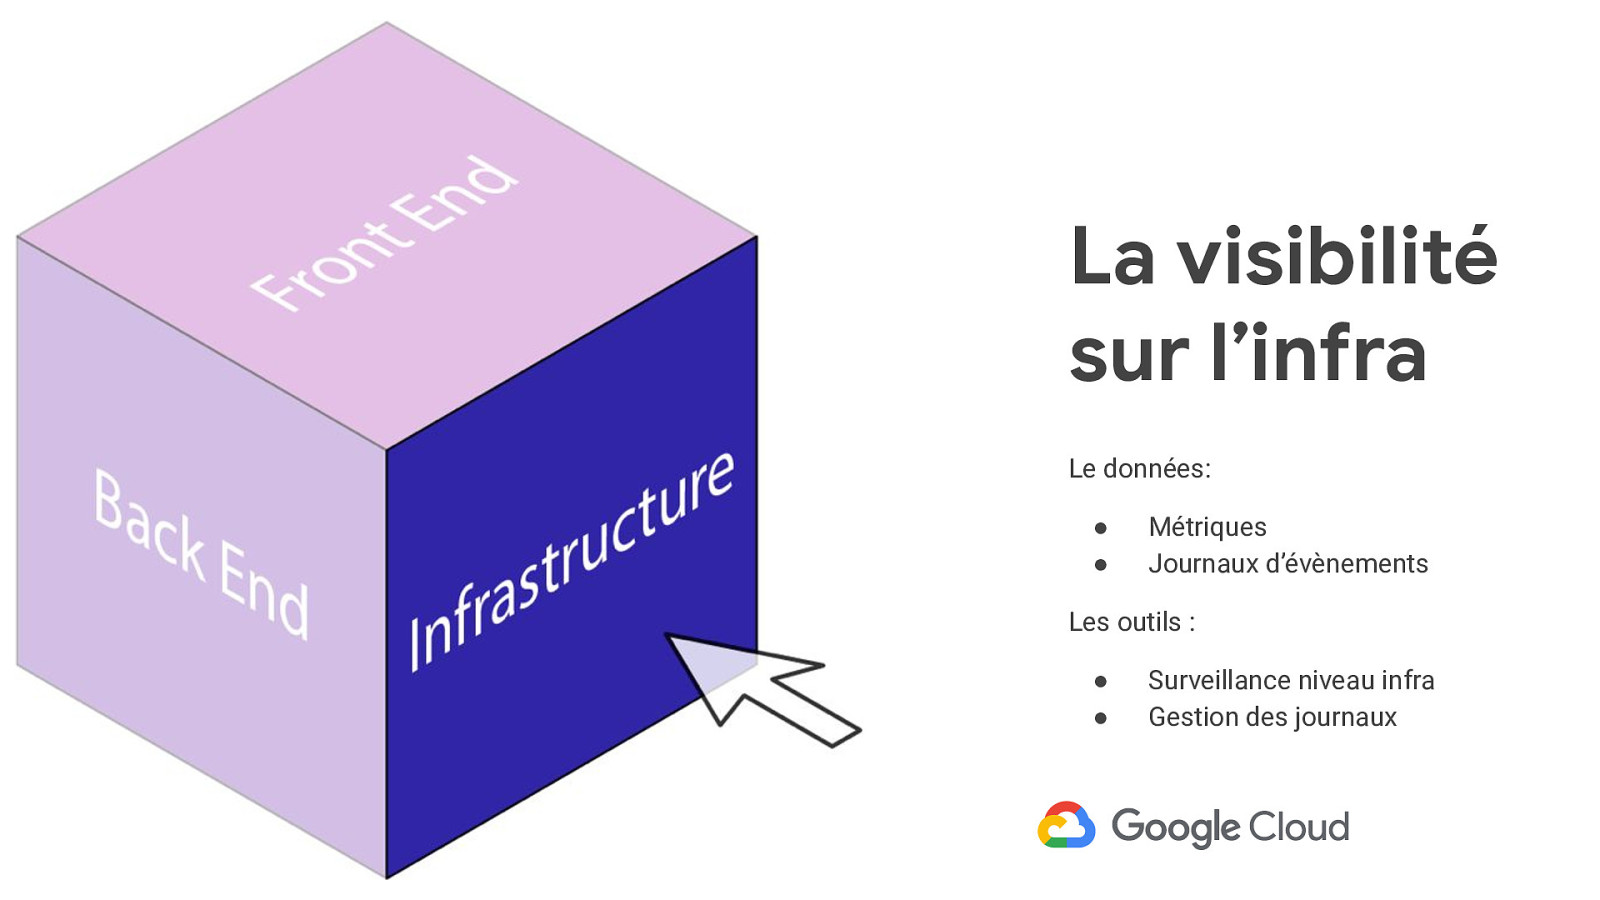
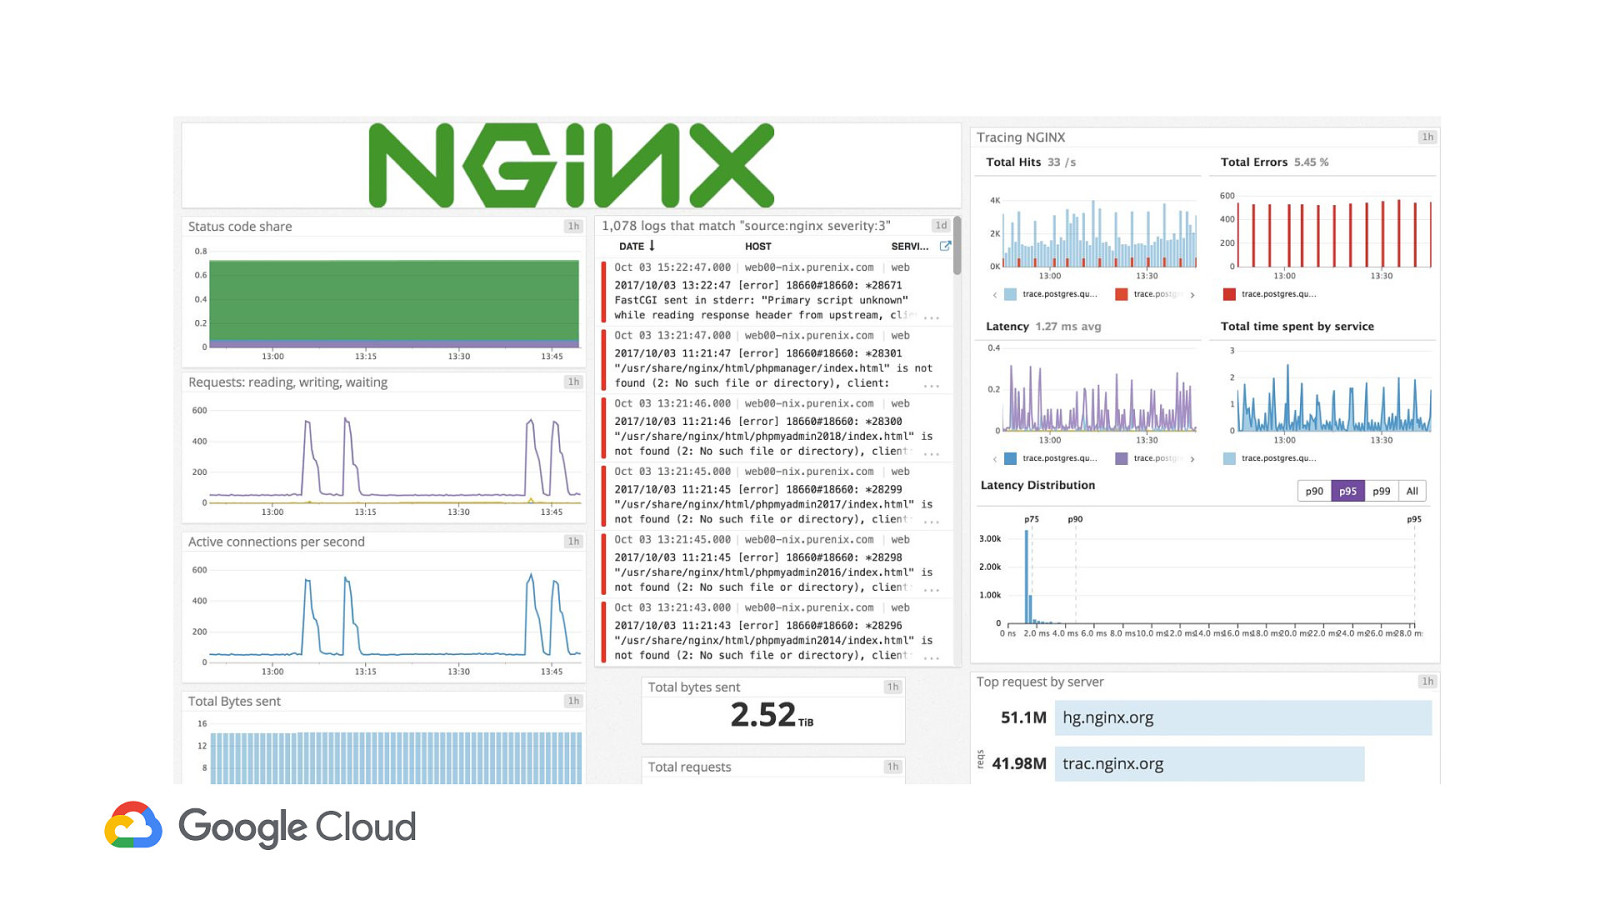
La visibilité sur l’infra Le données: ● ● Métriques Journaux d’évènements Les outils : ● ● Surveillance niveau infra Gestion des journaux
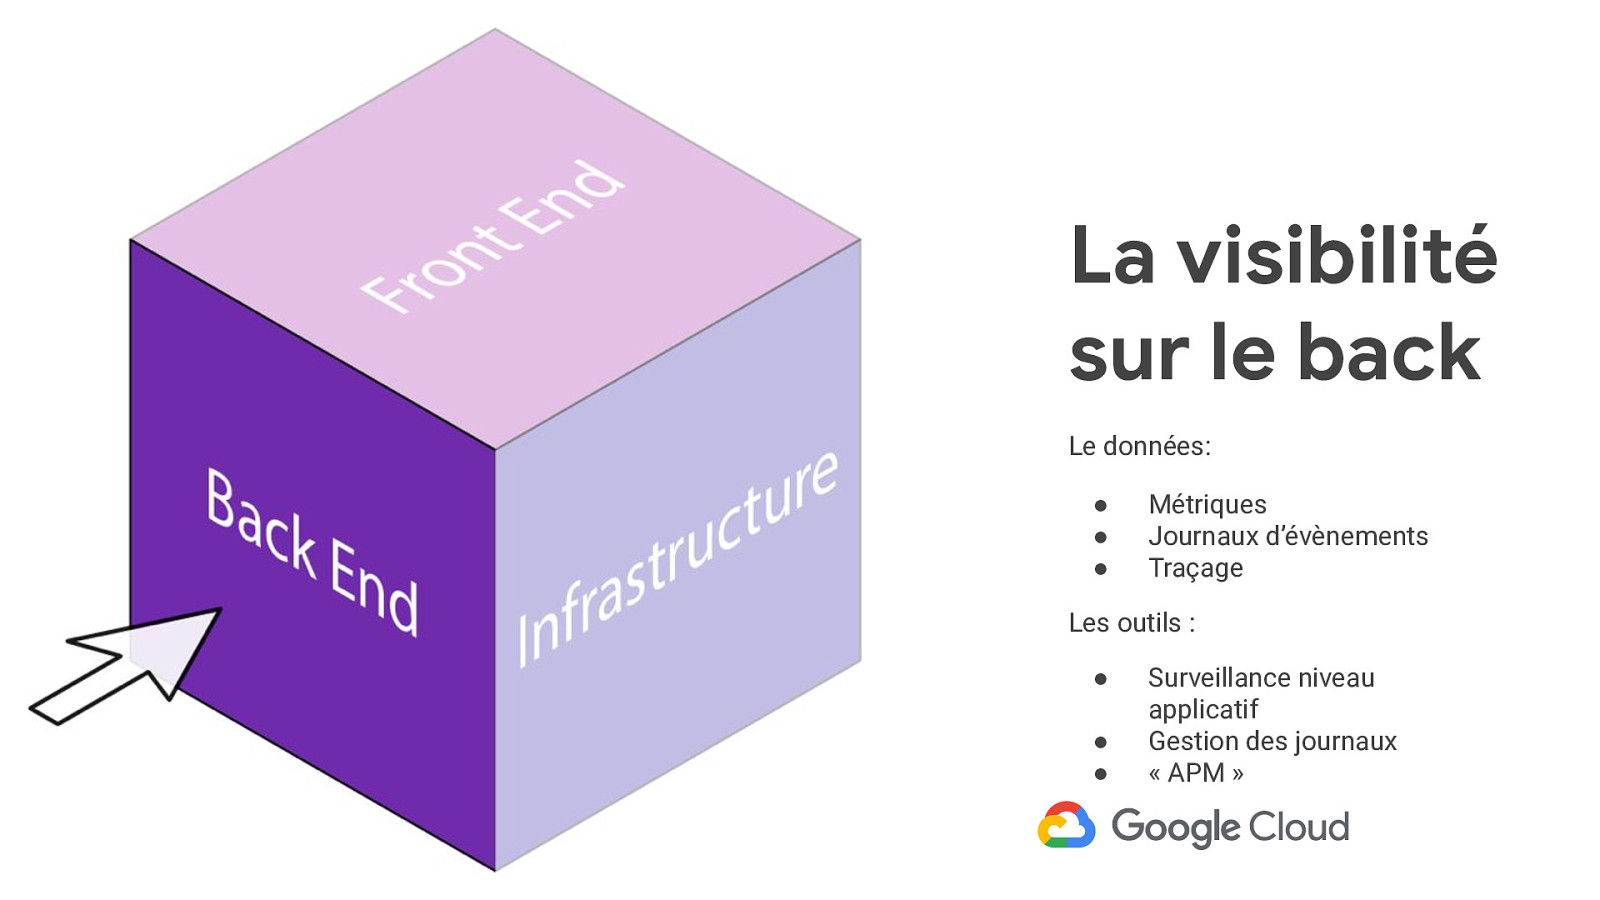
La visibilité sur le back Le données: ● ● ● Métriques Journaux d’évènements Traçage Les outils : ● ● ● Surveillance niveau applicatif Gestion des journaux « APM »
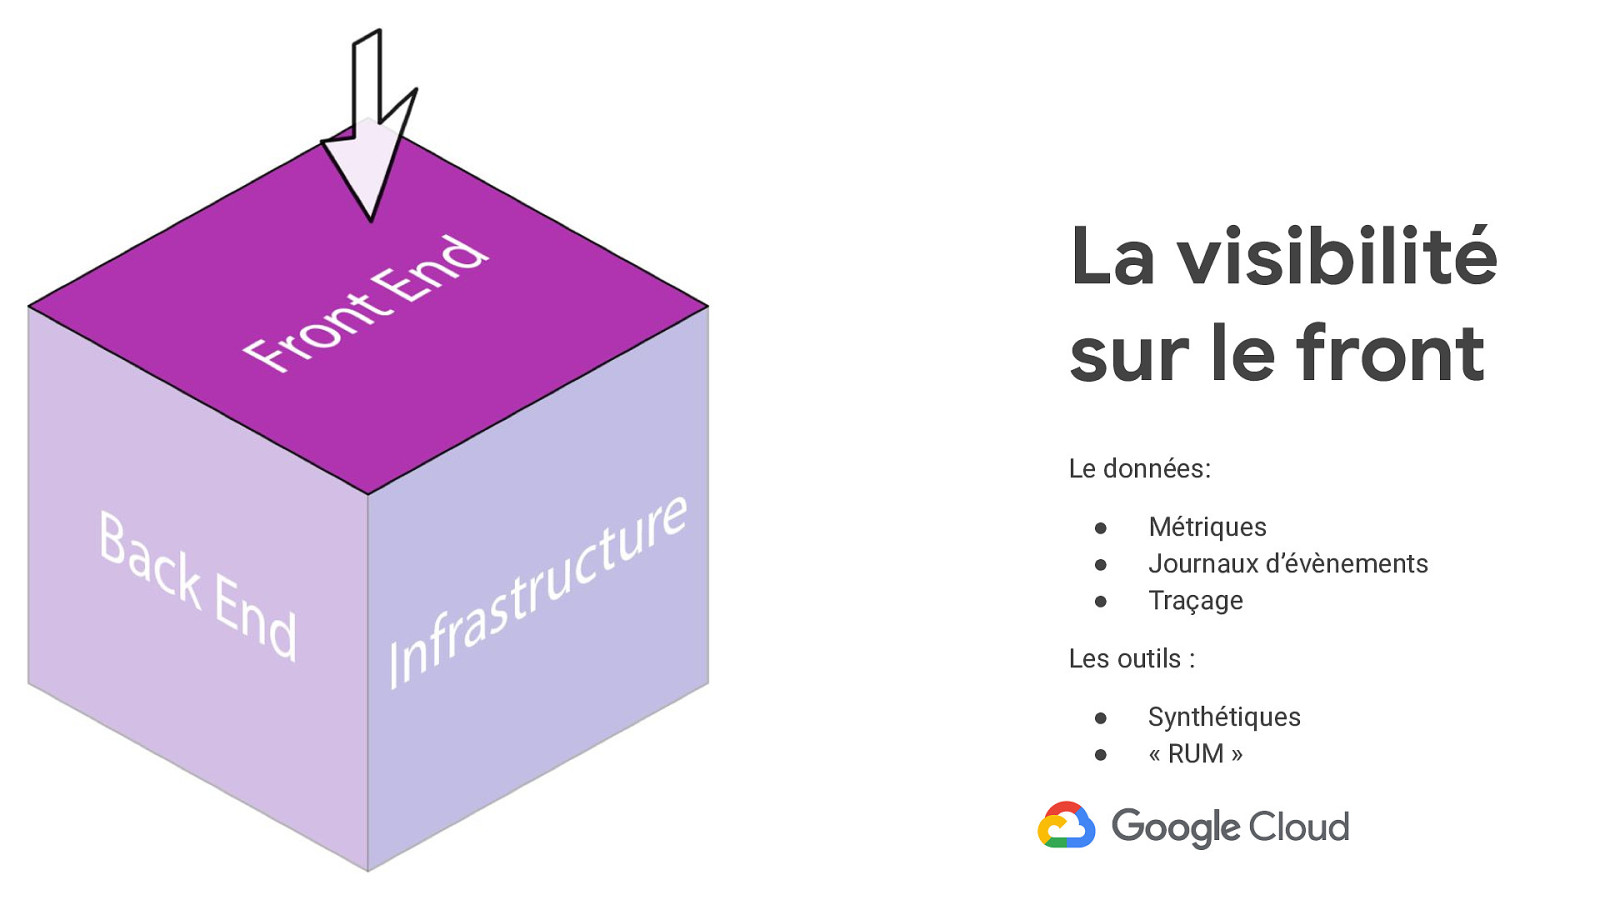
La visibilité sur le front Le données: ● ● ● Métriques Journaux d’évènements Traçage Les outils : ● ● Synthétiques « RUM »
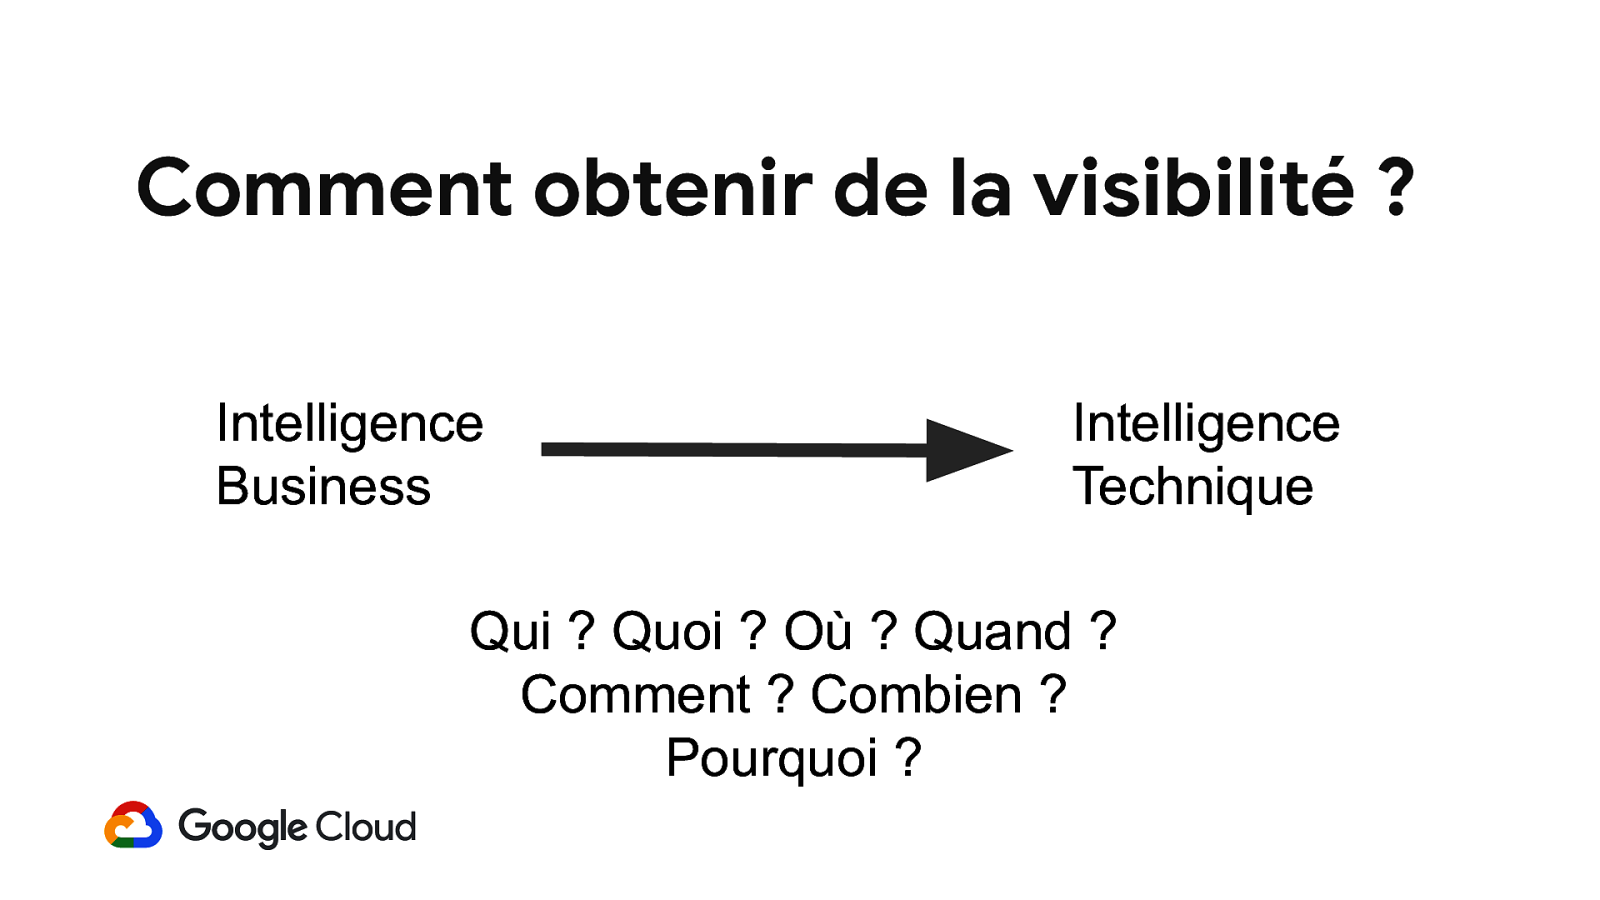
Comment obtenir de la visibilité ? Intelligence Business Intelligence Technique Qui ? Quoi ? Où ? Quand ? Comment ? Combien ? Pourquoi ?
Date-a-Dog Sortir avec un chiot. C’est une blague.
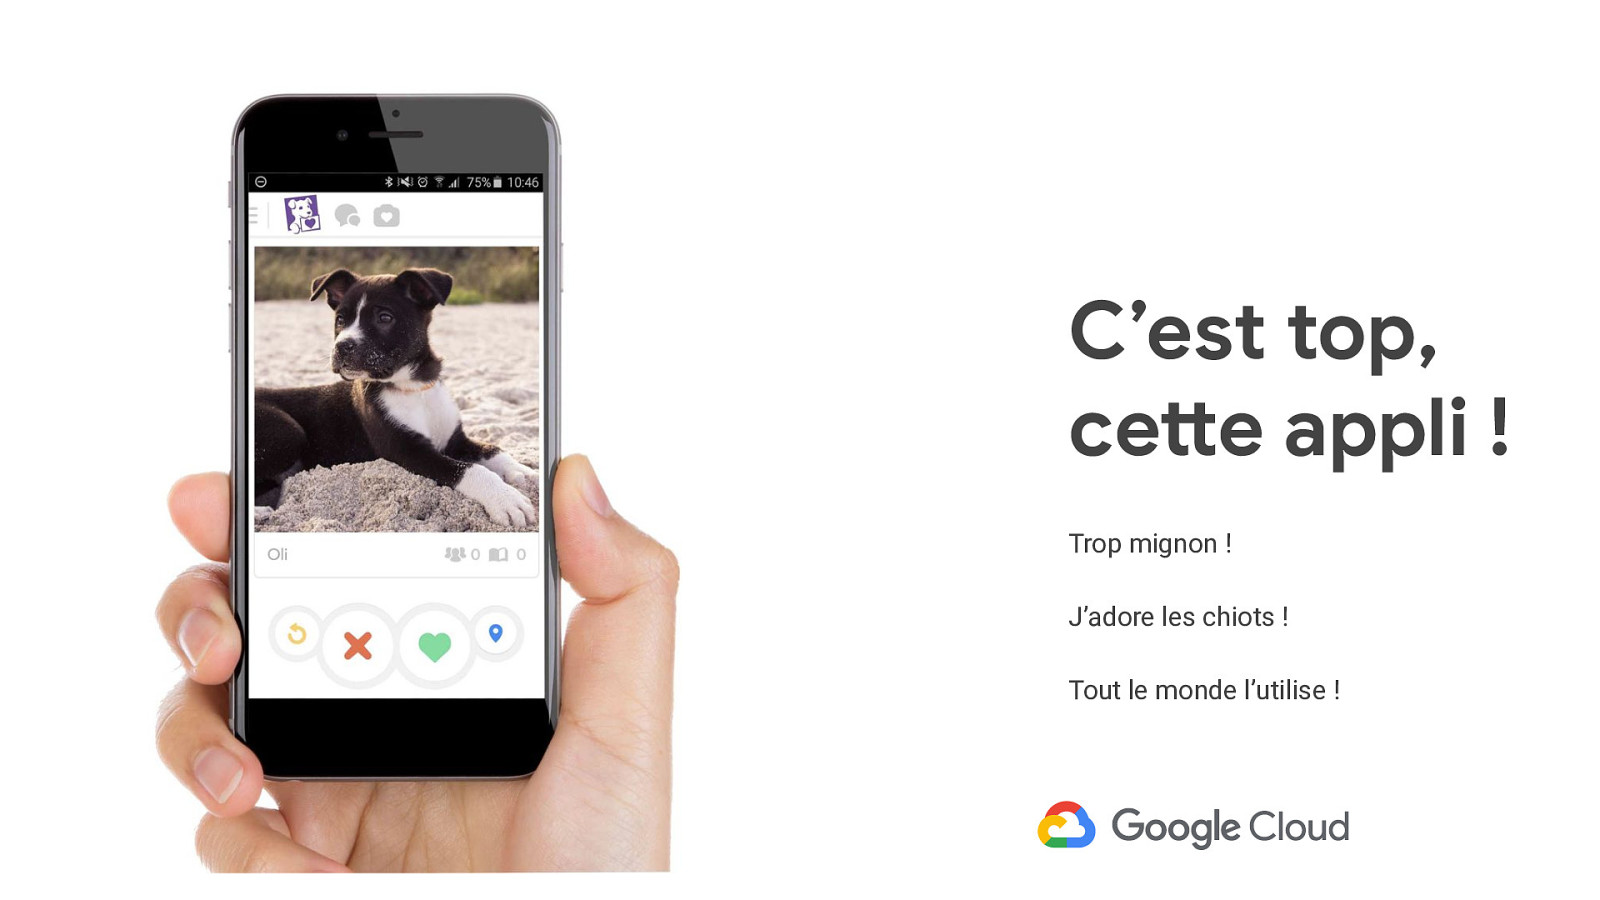
C’est top, cette appli ! Trop mignon ! J’adore les chiots ! Tout le monde l’utilise !
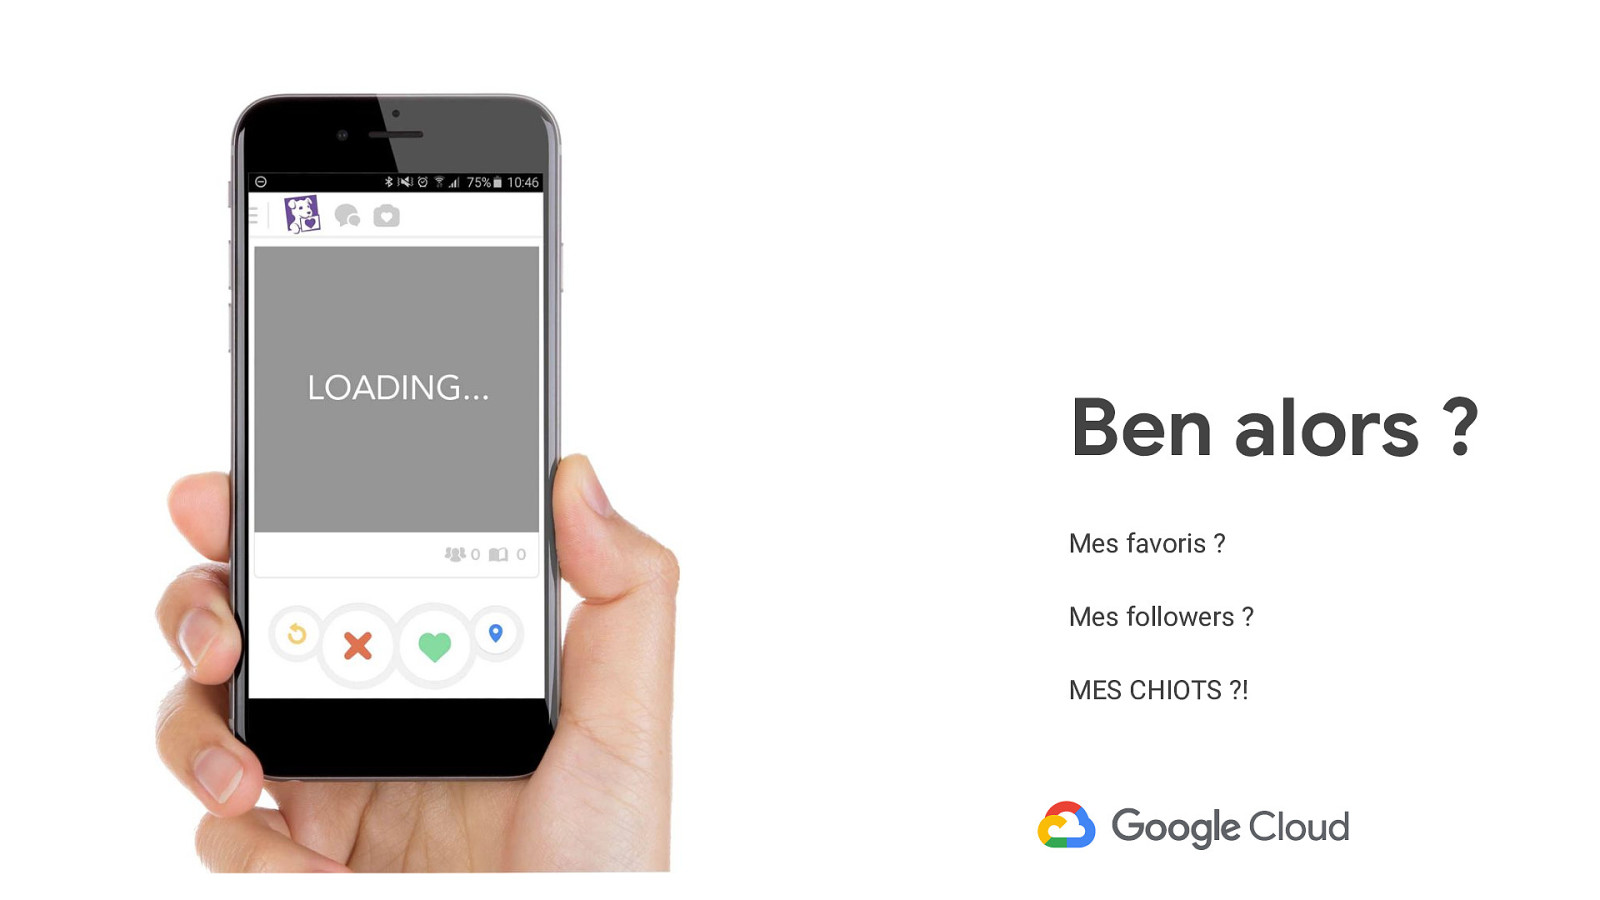
Ben alors ? Mes favoris ? Mes followers ? MES CHIOTS ?!
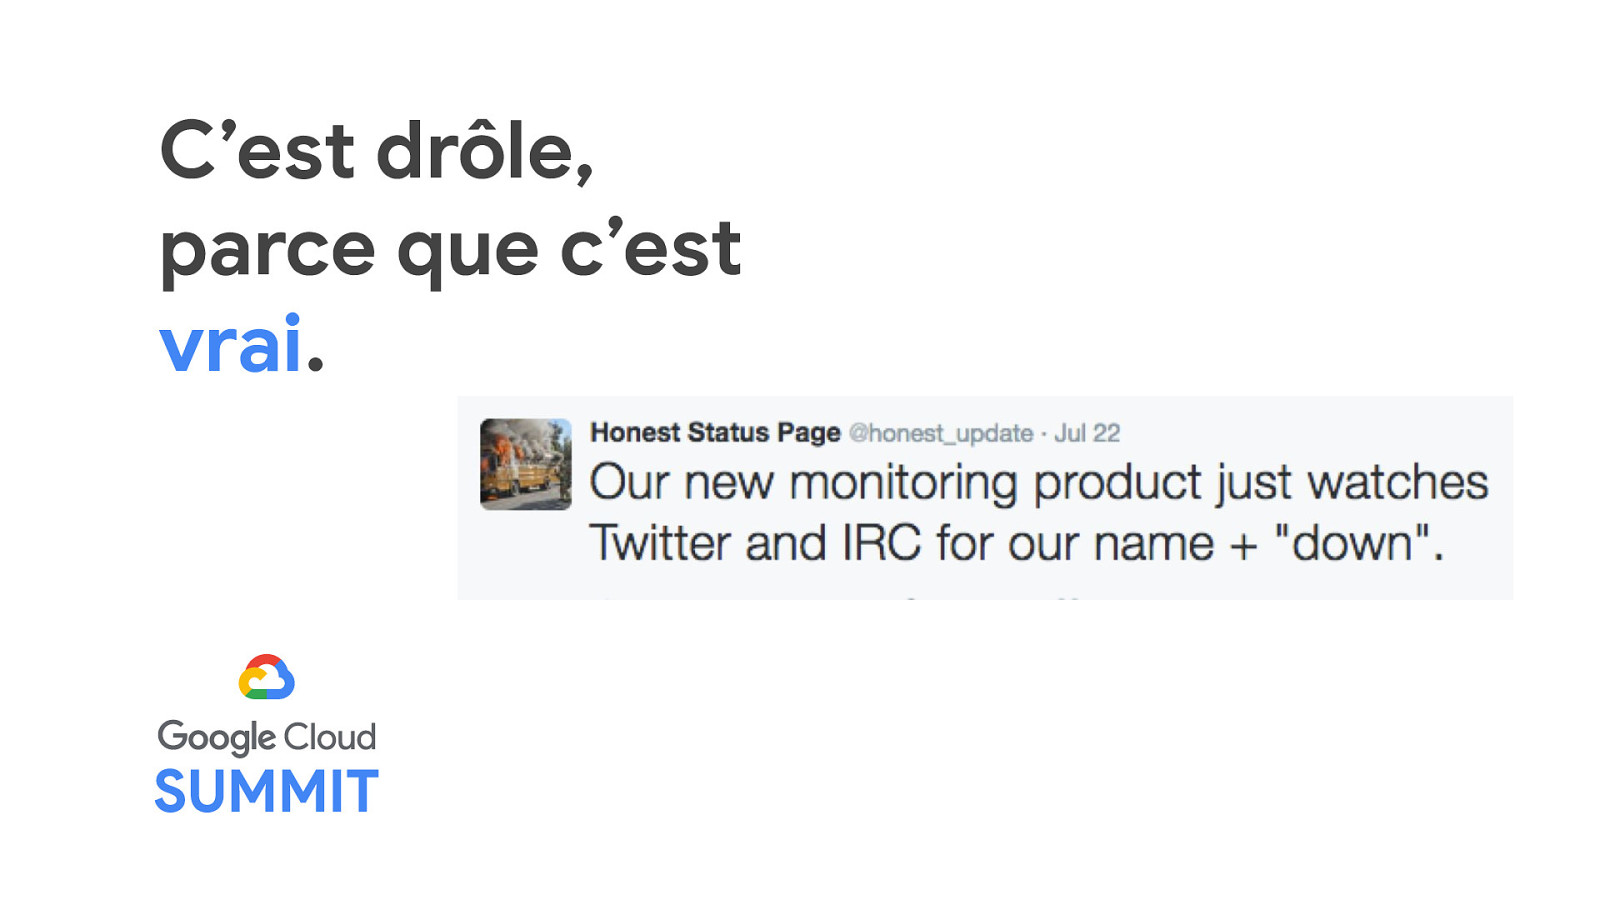
C’est drôle, parce que c’est vrai.
Comment pouvons-nous savoir si quelque chose c’est mal passé ? Vos utilisateurs le sauront - c’est certain.
RUM et Synthétiques « Real User Monitoring »
Scénario : panne de service RDC (CDN) ● Nous hébergeons les photos des chiots sur un réseau de diffusion de contenu (RDC, ou « CDN » en anglais), ce qui est un service tier. ● L’application mobile télécharge les images directement à partir de ce service. ● Le RDC devient la cible d’une attaque par déni de service distribué (DDoS) massive.
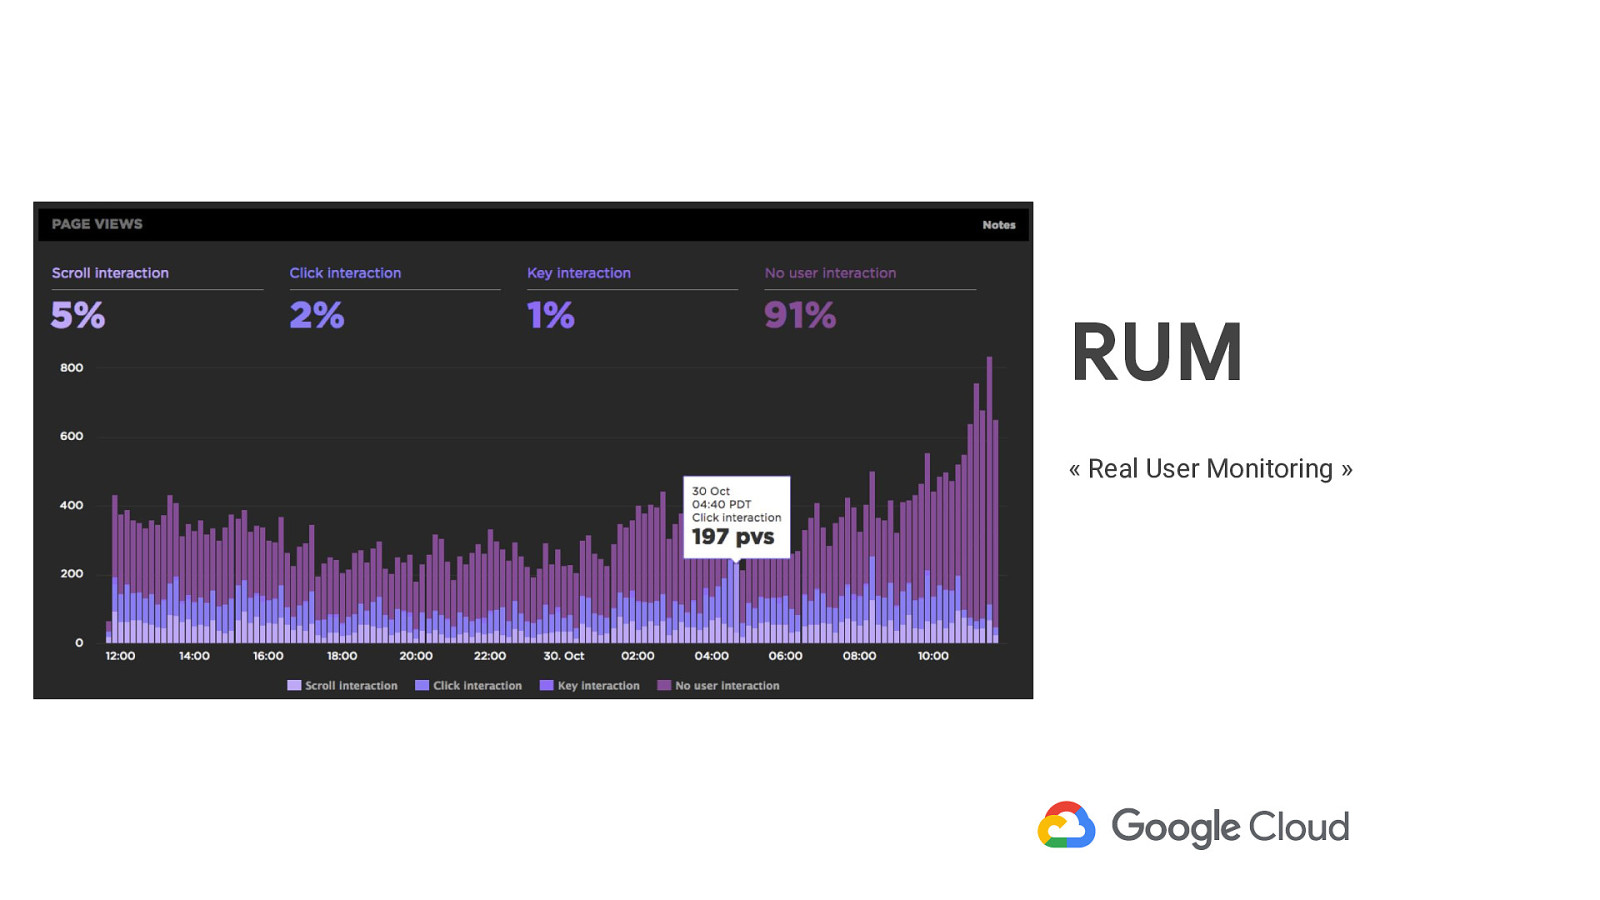
RUM « Real User Monitoring »
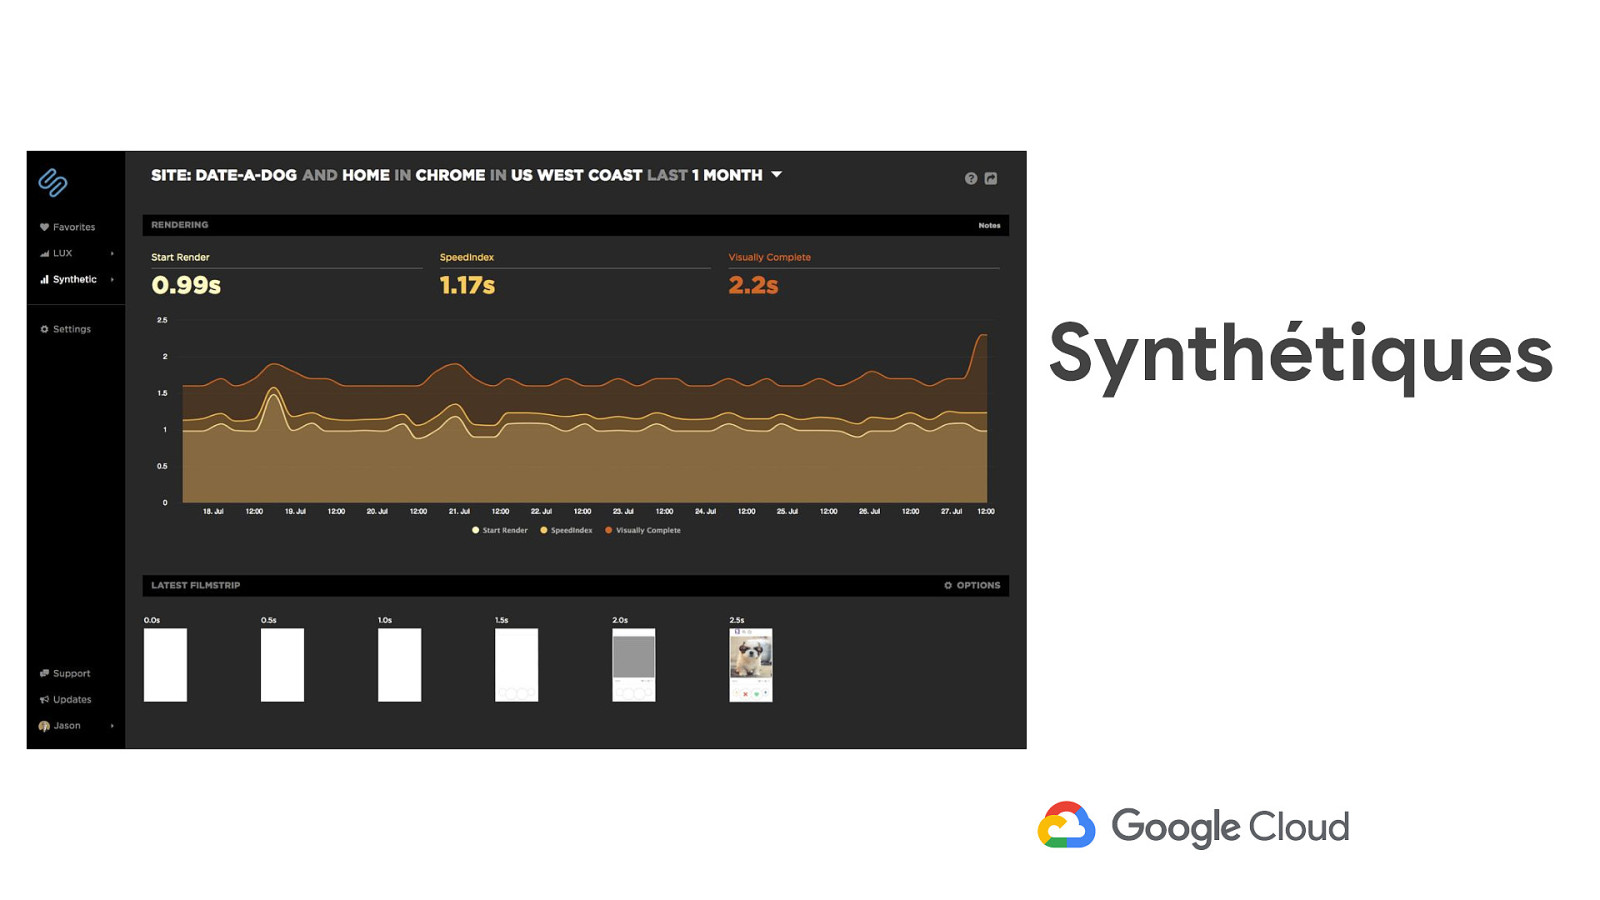
Synthétiques
Scénario : panne de service RDC (CDN) ● Selon la supervision d’infrastructure : OK ● Selon la supervision d’application : OK ● Selon APM : OK ● Selon RUM et Synthétiques : ALERTE ! Possibilité de montrer aussi les actifs lents ou inaccessibles.
Traçage et APM « Tracing and Application Performance Monitoring »
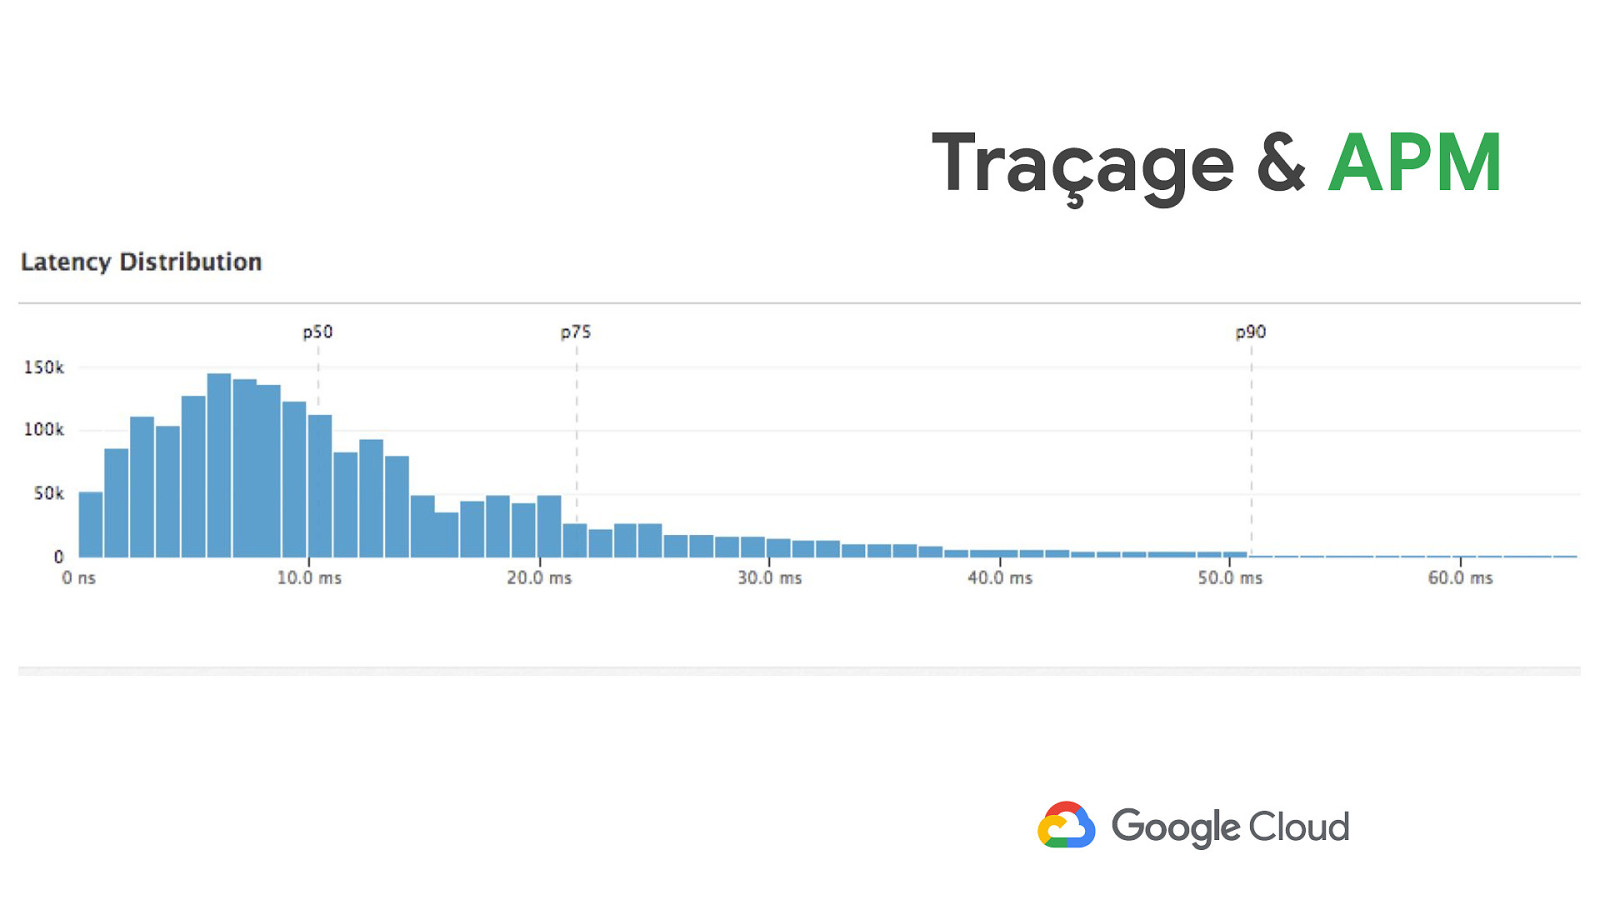
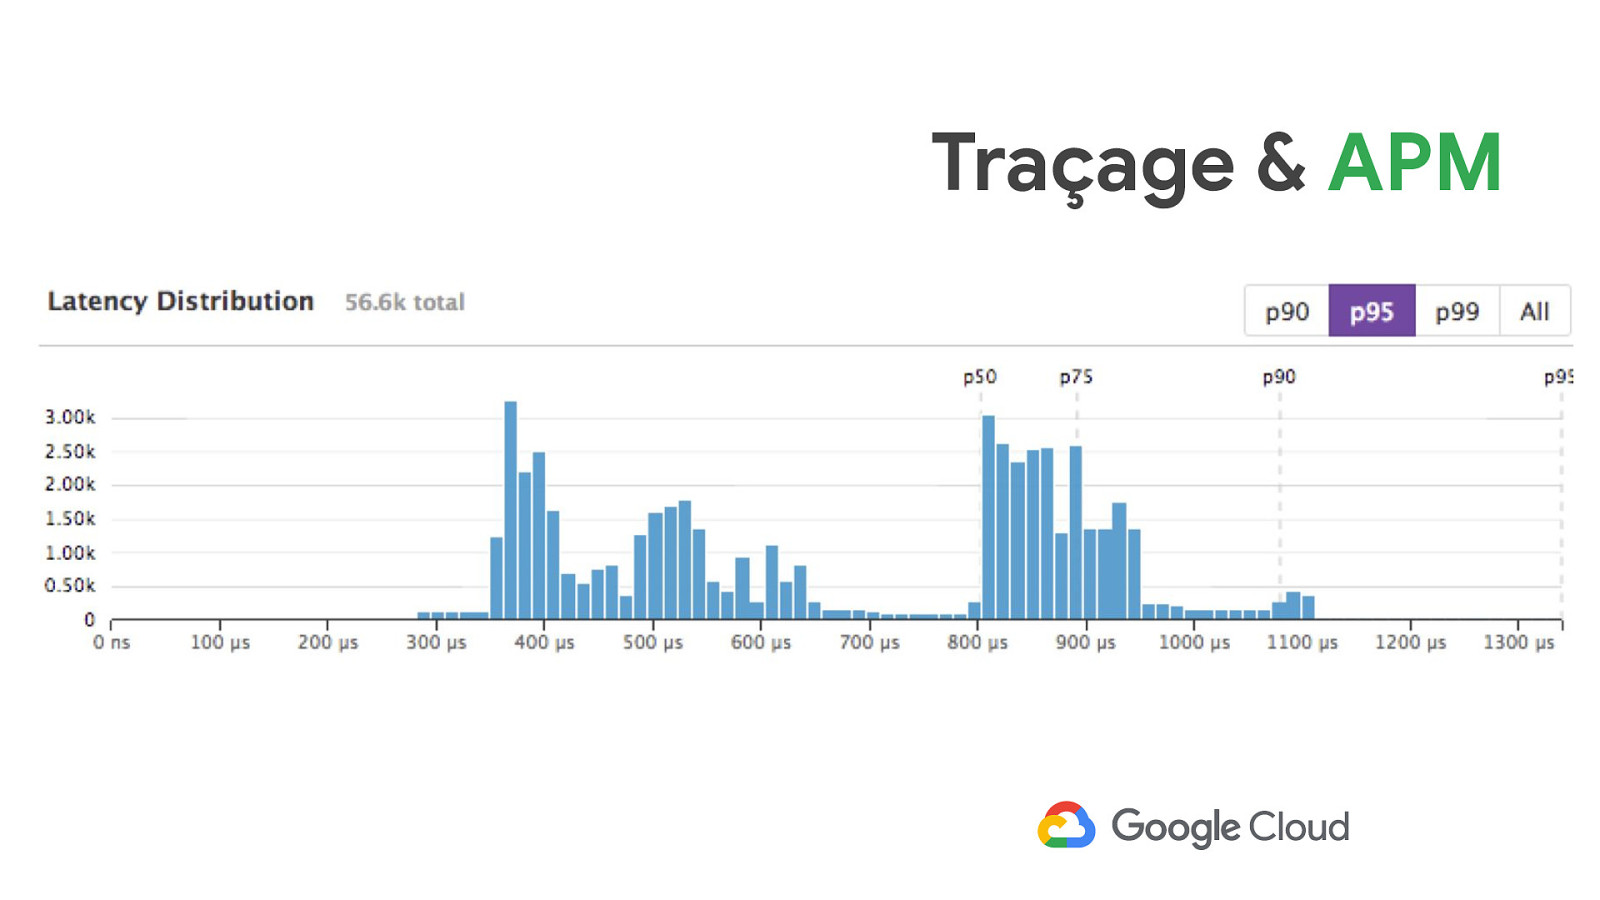
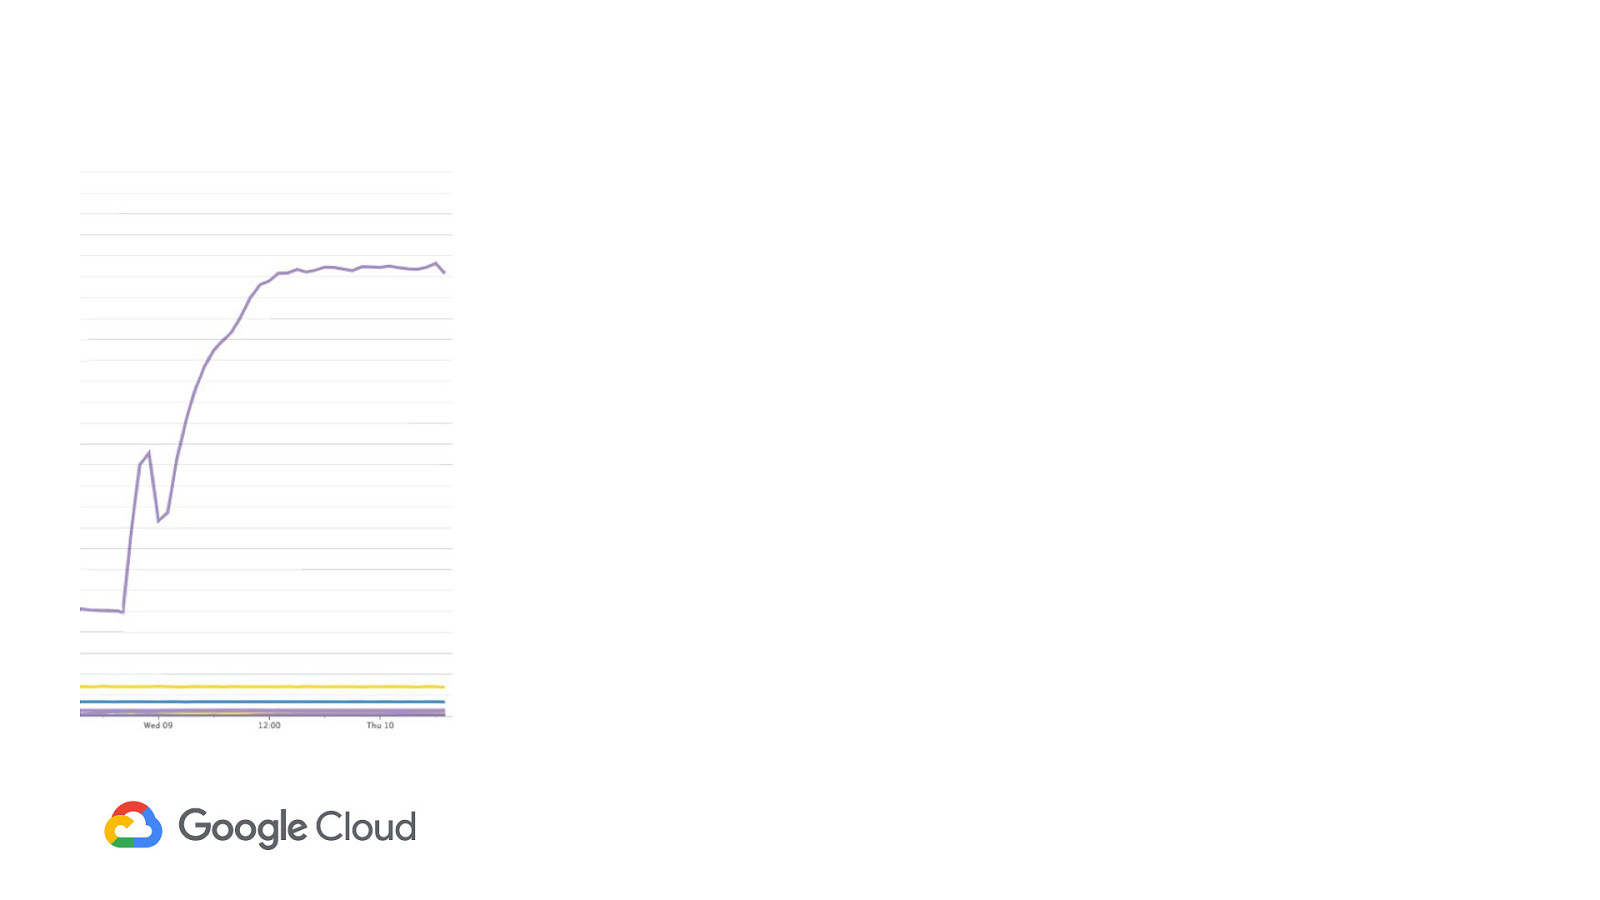
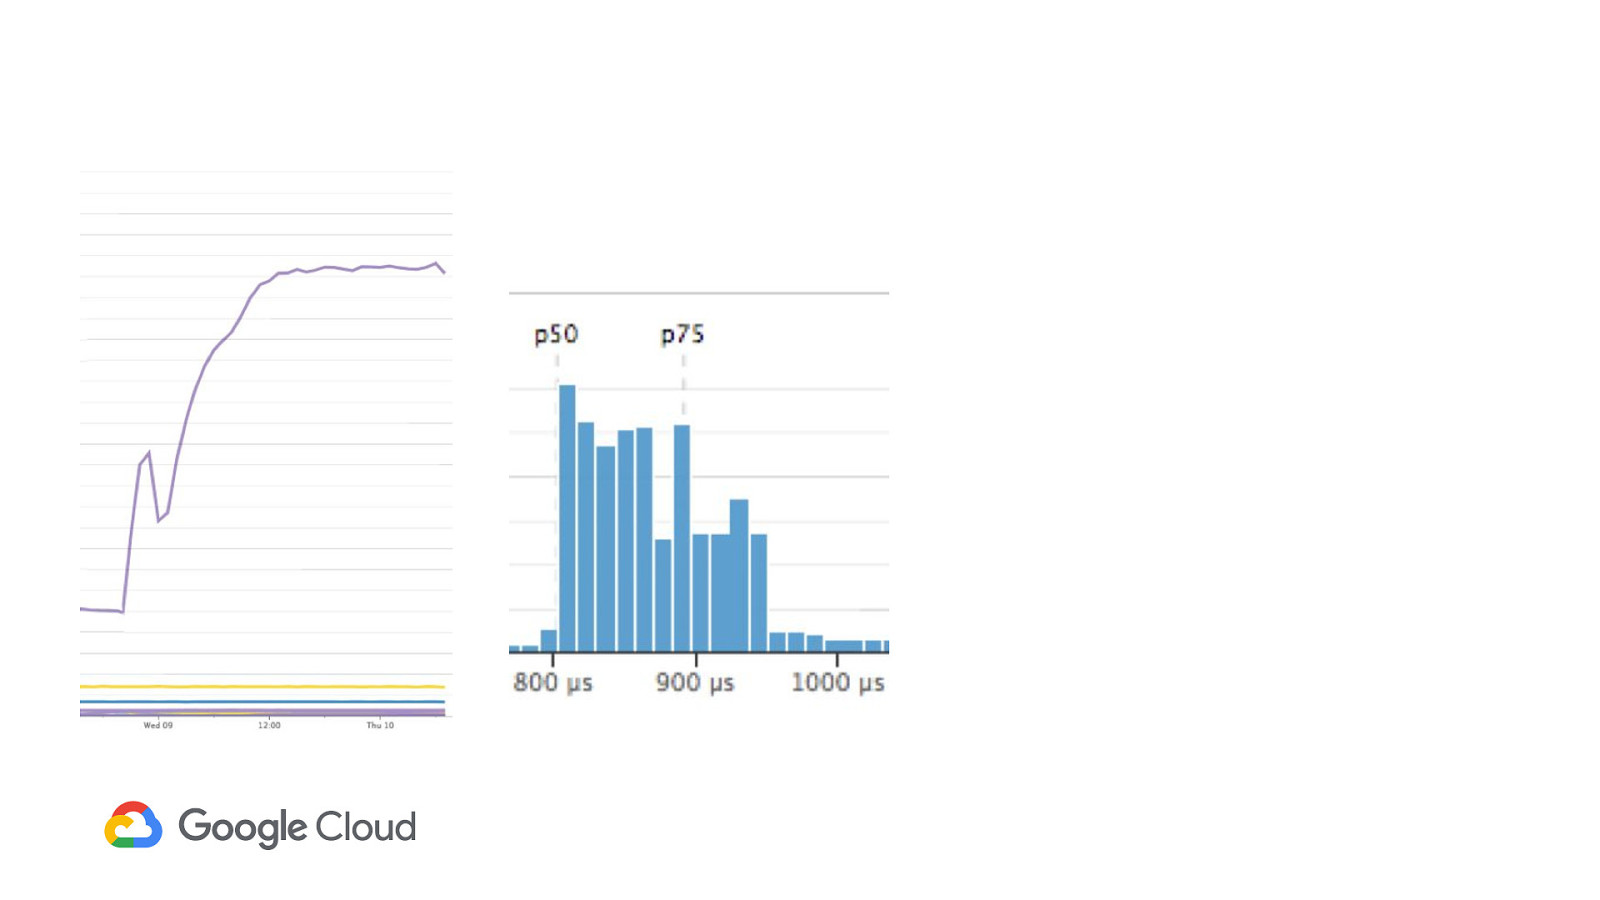
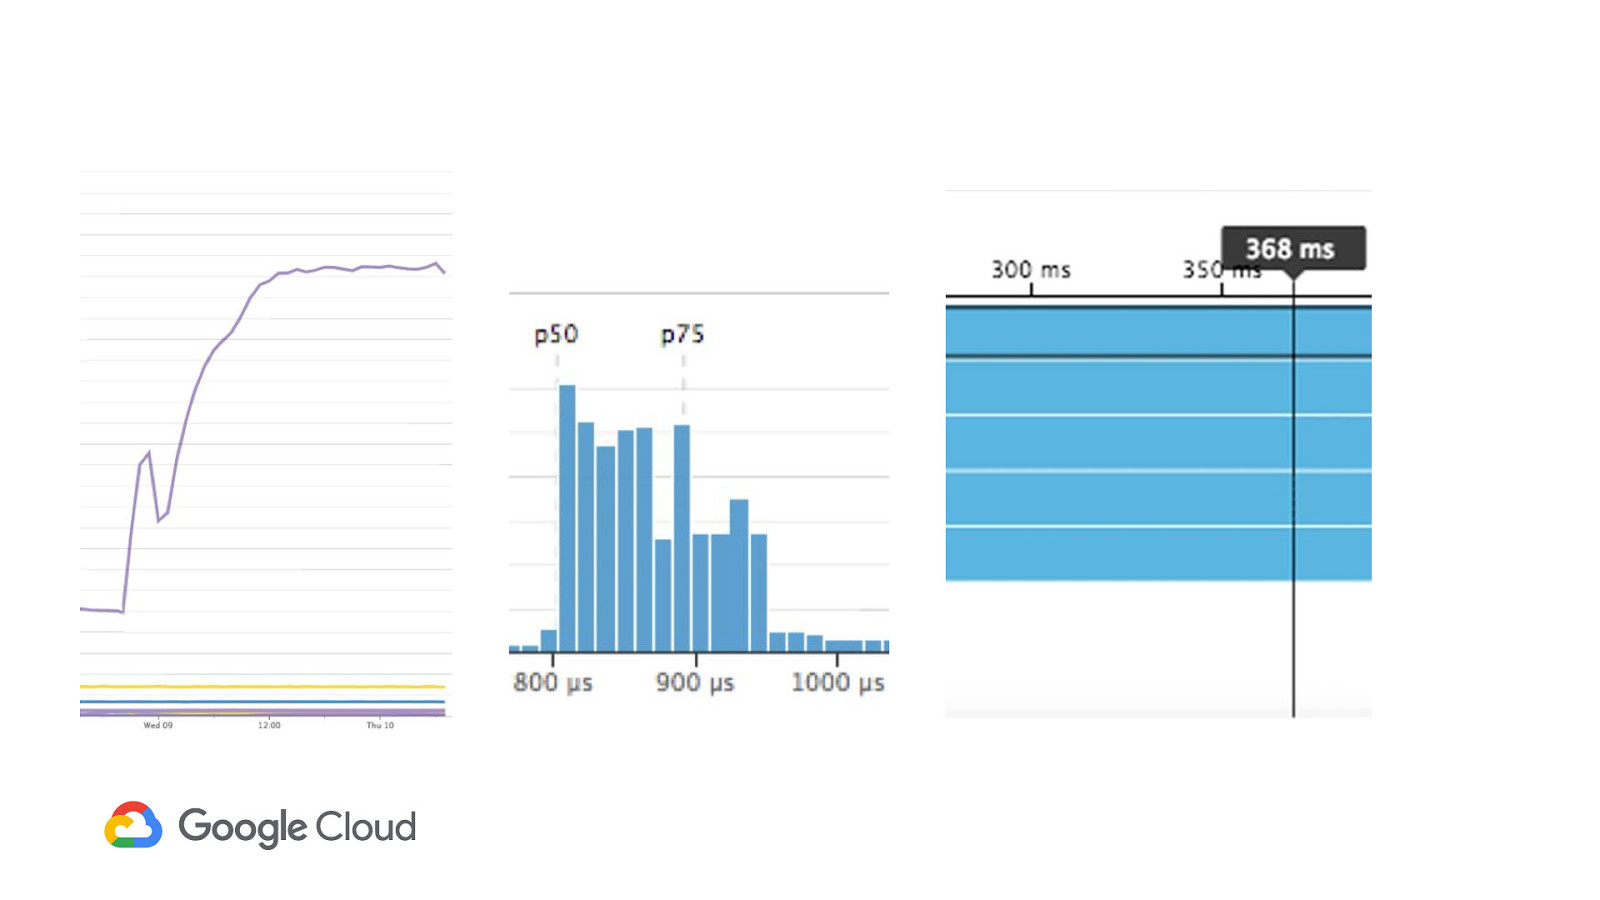
Scénario : panne de service du ● Nous utilisons un service de redimensionnement et optimisation d’image qui redimensionne les images de manière asynchrone. ● Le service fonctionne d’une manière aléatoire - certaines images sont traitées rapidement, d’autres mettre beaucoup plus de temps. ● Impossible de régler nous mêmes car la situation et hors de notre contrôle. redimensionnement
Traçage & APM
Traçage & APM
Traçage & APM
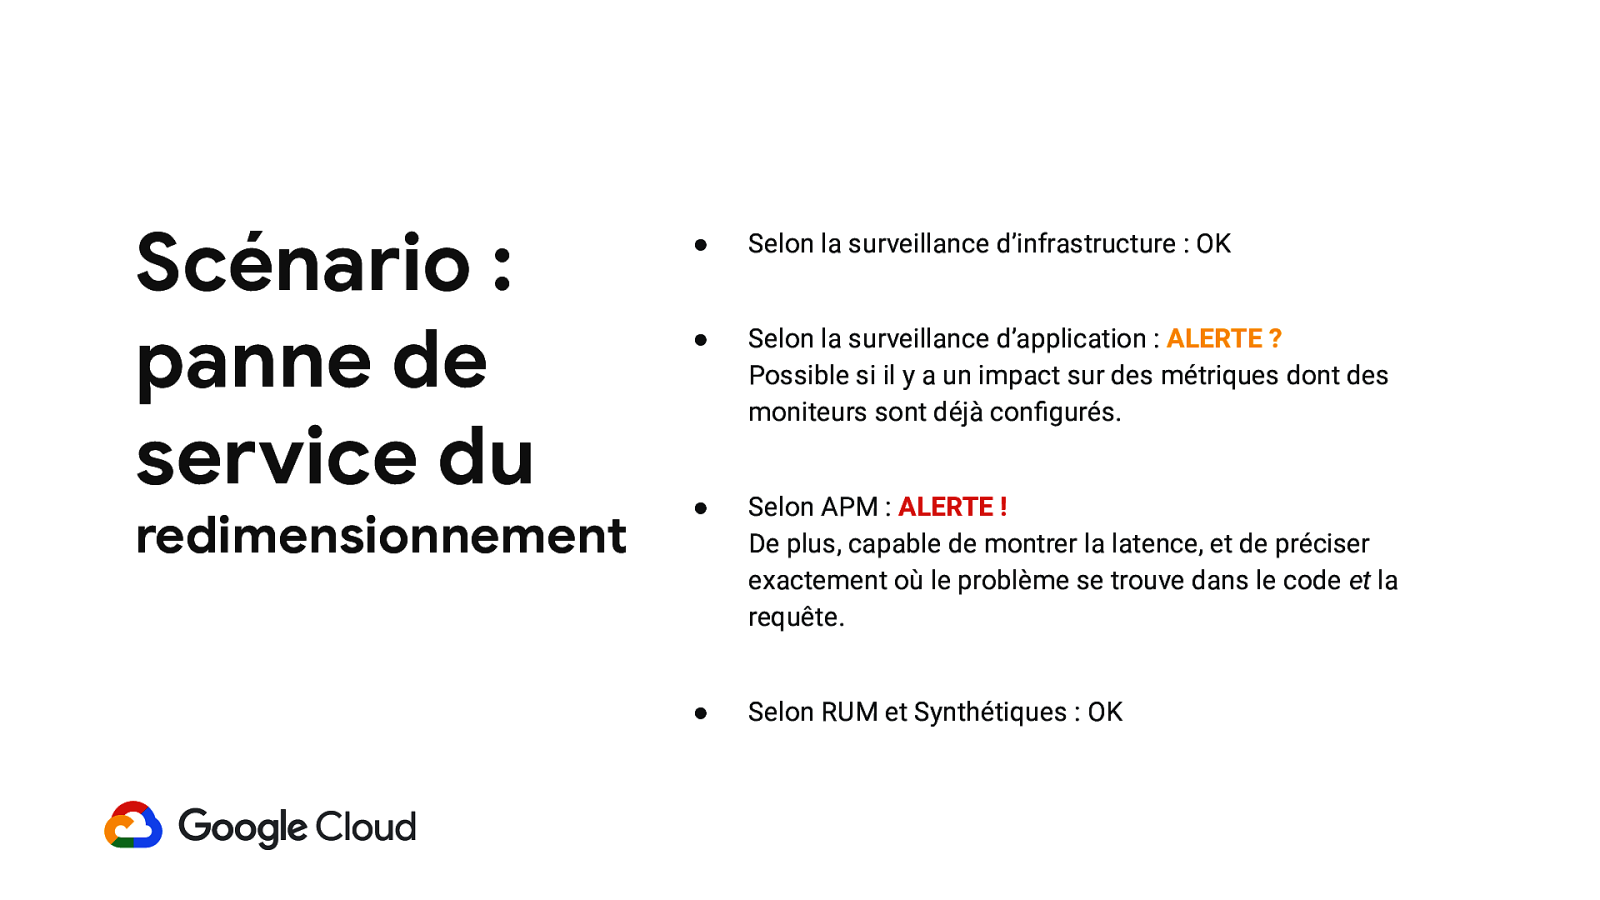
Scénario : panne de service du redimensionnement ● Selon la surveillance d’infrastructure : OK ● Selon la surveillance d’application : ALERTE ? Possible si il y a un impact sur des métriques dont des moniteurs sont déjà configurés. ● Selon APM : ALERTE ! De plus, capable de montrer la latence, et de préciser exactement où le problème se trouve dans le code et la requête. ● Selon RUM et Synthétiques : OK
Surveillance d’Application « Application Monitoring »
Scénario : du code bogué est déployé ● Une section de code qui interagit avec le mécanisme de connexion. ● Utilise la mauvaise technique de hachage - les utilisateurs ne peuvent plus s’authentifier ! Catastrophe ! ● Entièrement possible que le code est structuré correctement et donc indétectable par les tests automatisés.
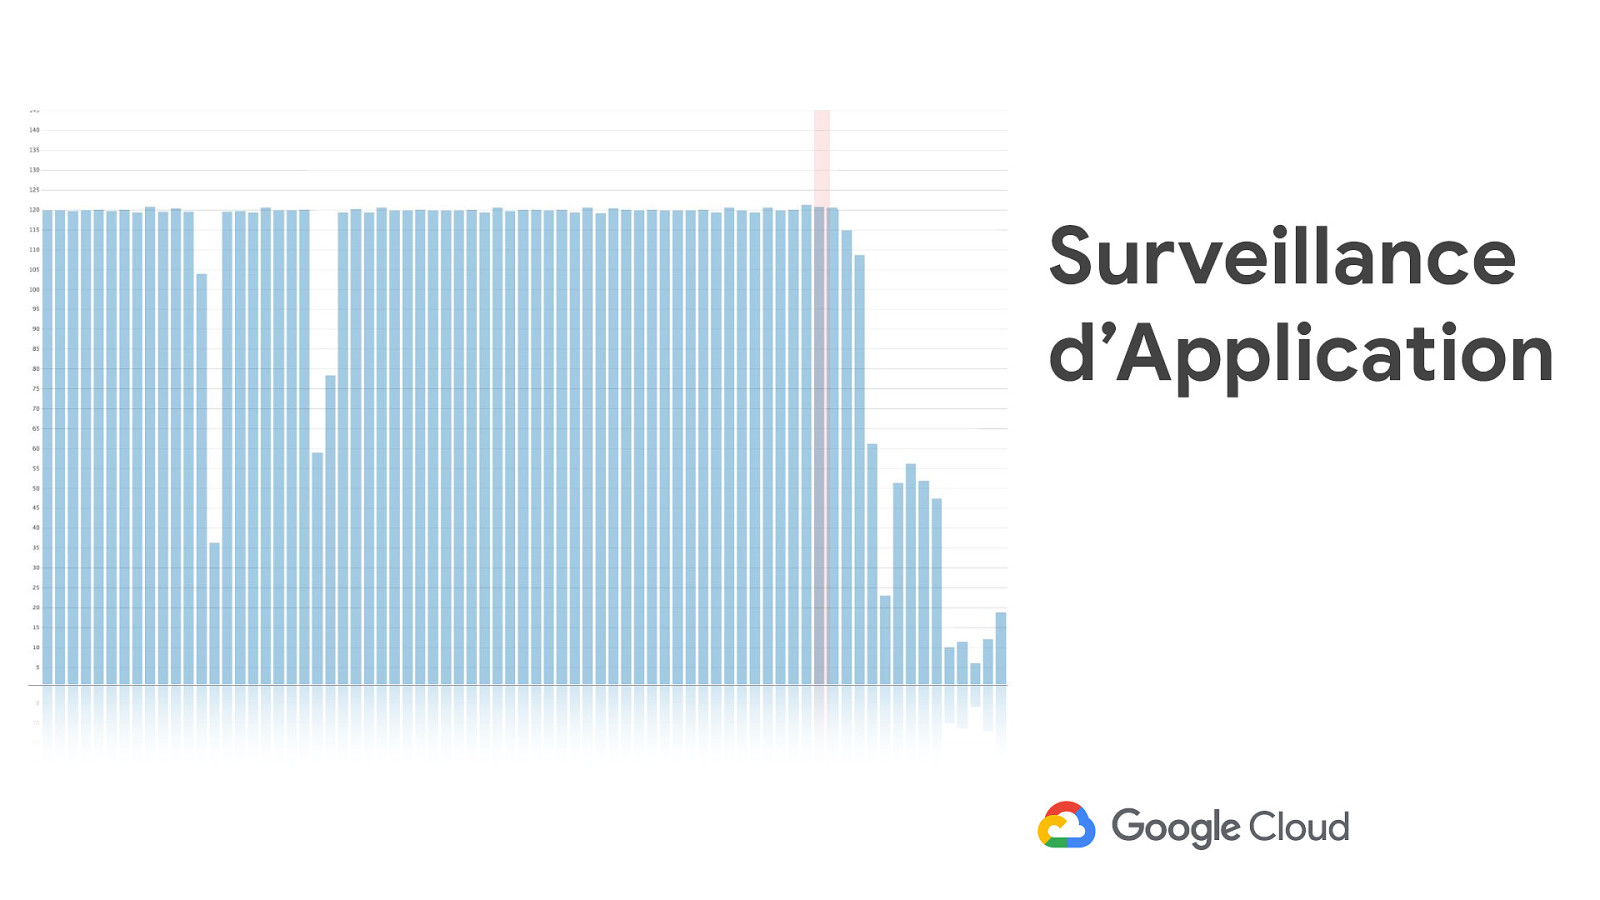
Surveillance d’Application
Scénario : du code bogué est déployé ● Selon la surveillance d’infrastructure : OK ● Selon la surveillance d’application : ALERTE ! De plus, elle identifiera l’impact sur les mesures personnalisées et peut aider à identifier le « pourquoi » . ● Selon APM : OK ● Selon RUM et Synthétiques : OK
Surveillance d’Infrastructure « Infrastructure Monitoring »
Scénario : juste trop populaire ! ● Les gens adorent les chiots et l’application est un succès monumentale (bravo) ! ● Oups - nous n’avons plus de ressources côté serveur pour répondre à toutes les demandes! ● C’est un bon problème à subir, mais ça reste un problème quand même.
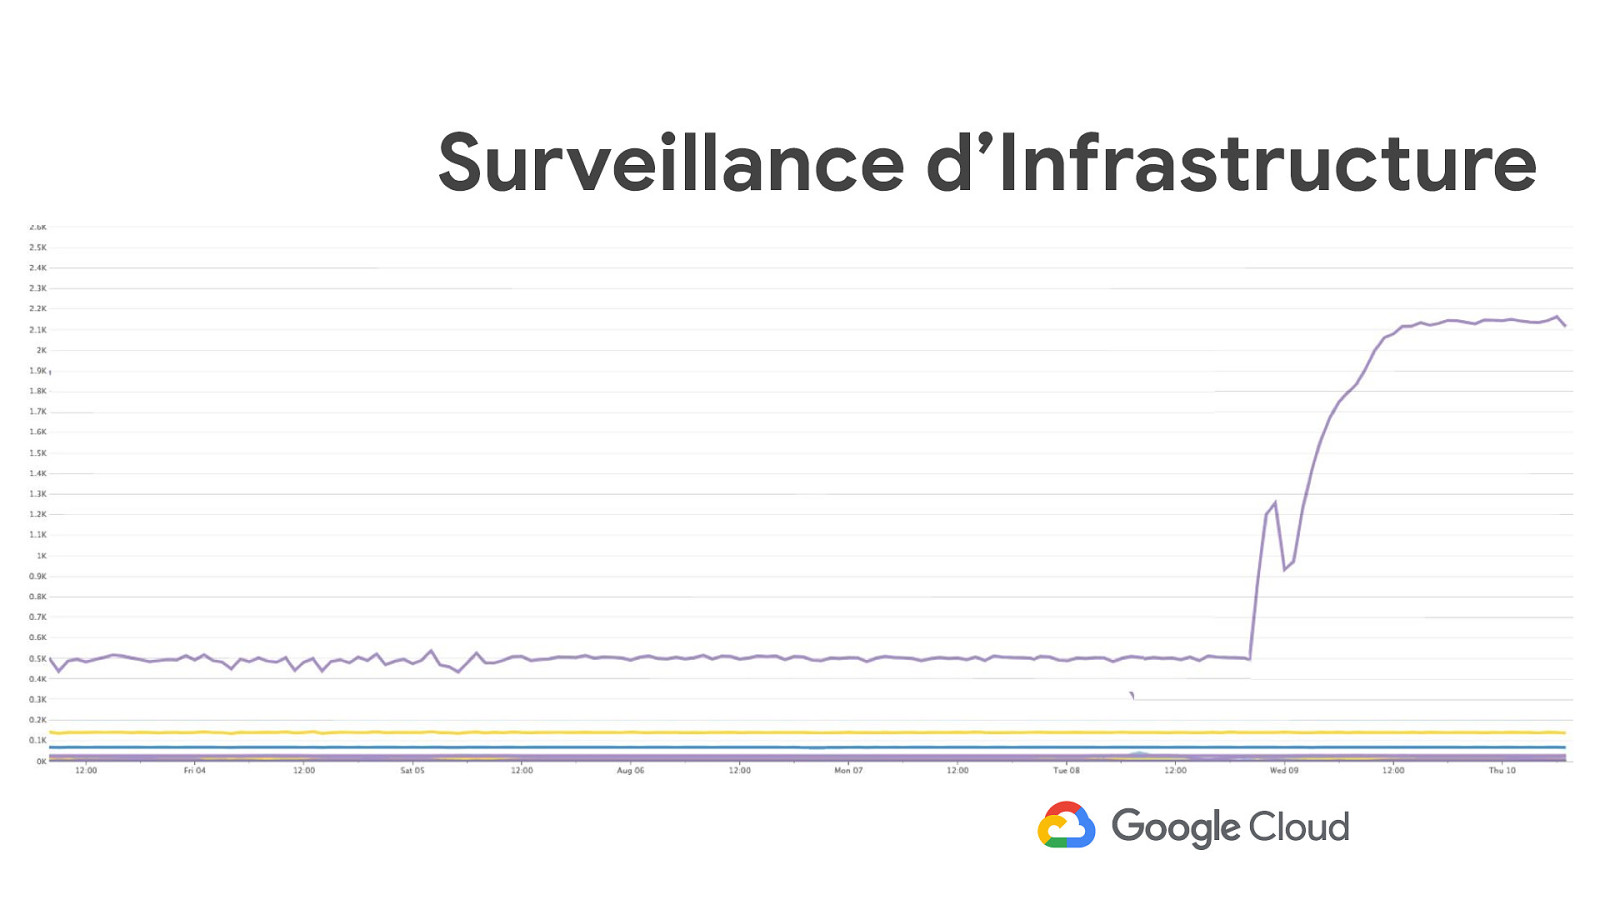
Surveillance d’Infrastructure
Scénario : juste trop populaire ! ● Selon la surveillance d’infrastructure : ALERTE ! Identifiera le problème, son endroit précis dans l’infra, et peut même déclencher une remédiation automatique. ● Selon la surveillance d’application : OK ● Selon APM : OK ● Selon RUM et Synthétiques : OK
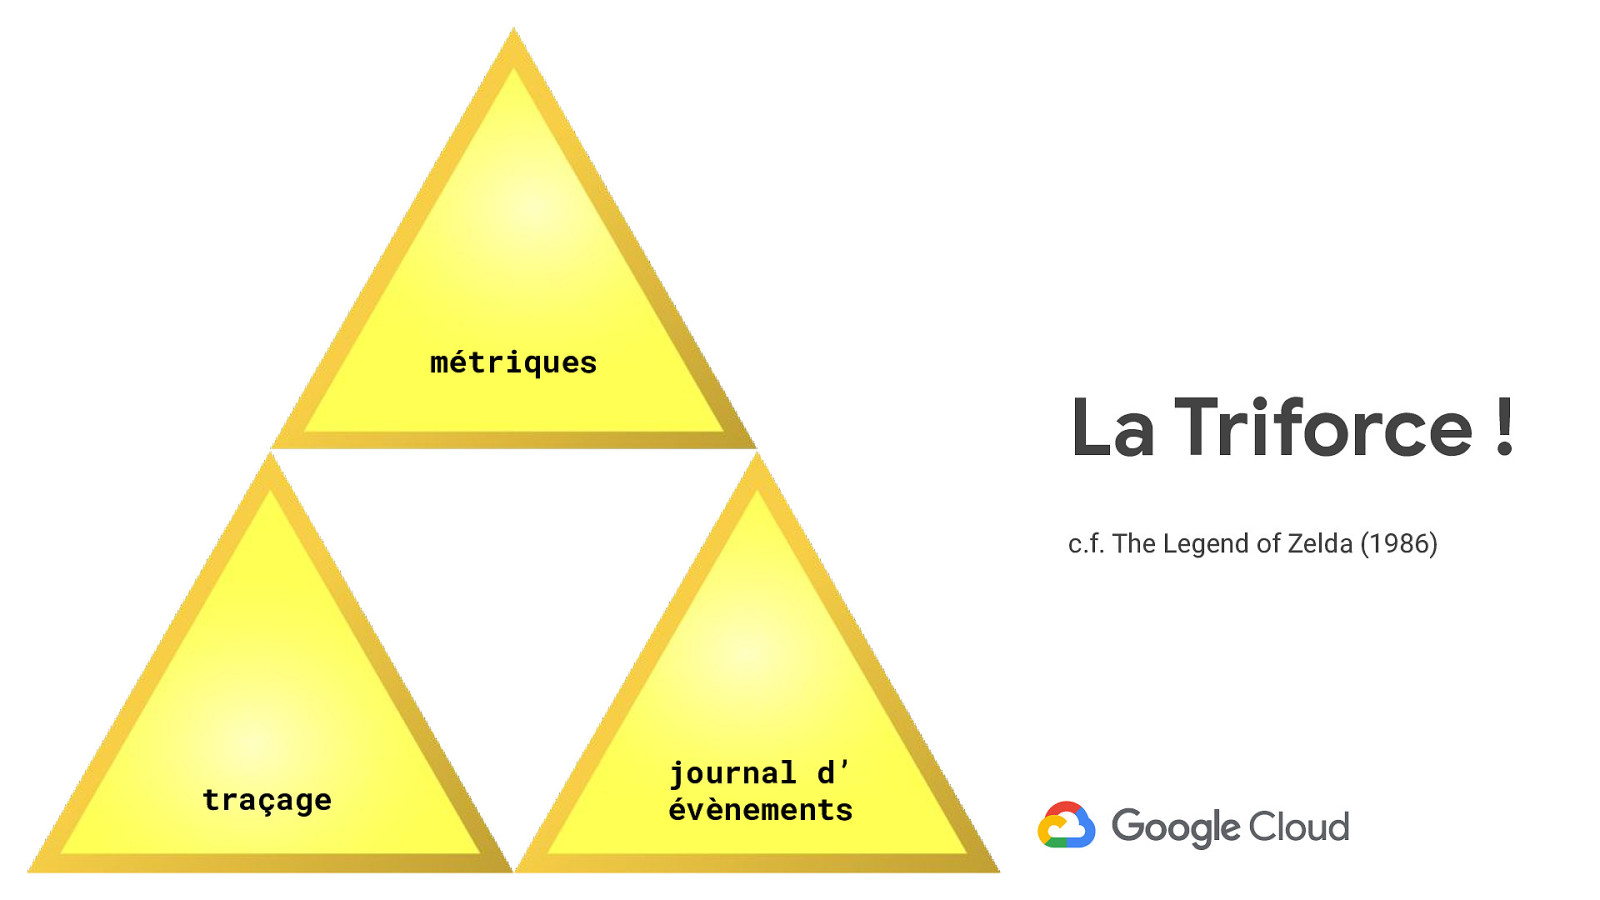
métriques La Triforce ! c.f. The Legend of Zelda (1986) traçage journal d’ évènements
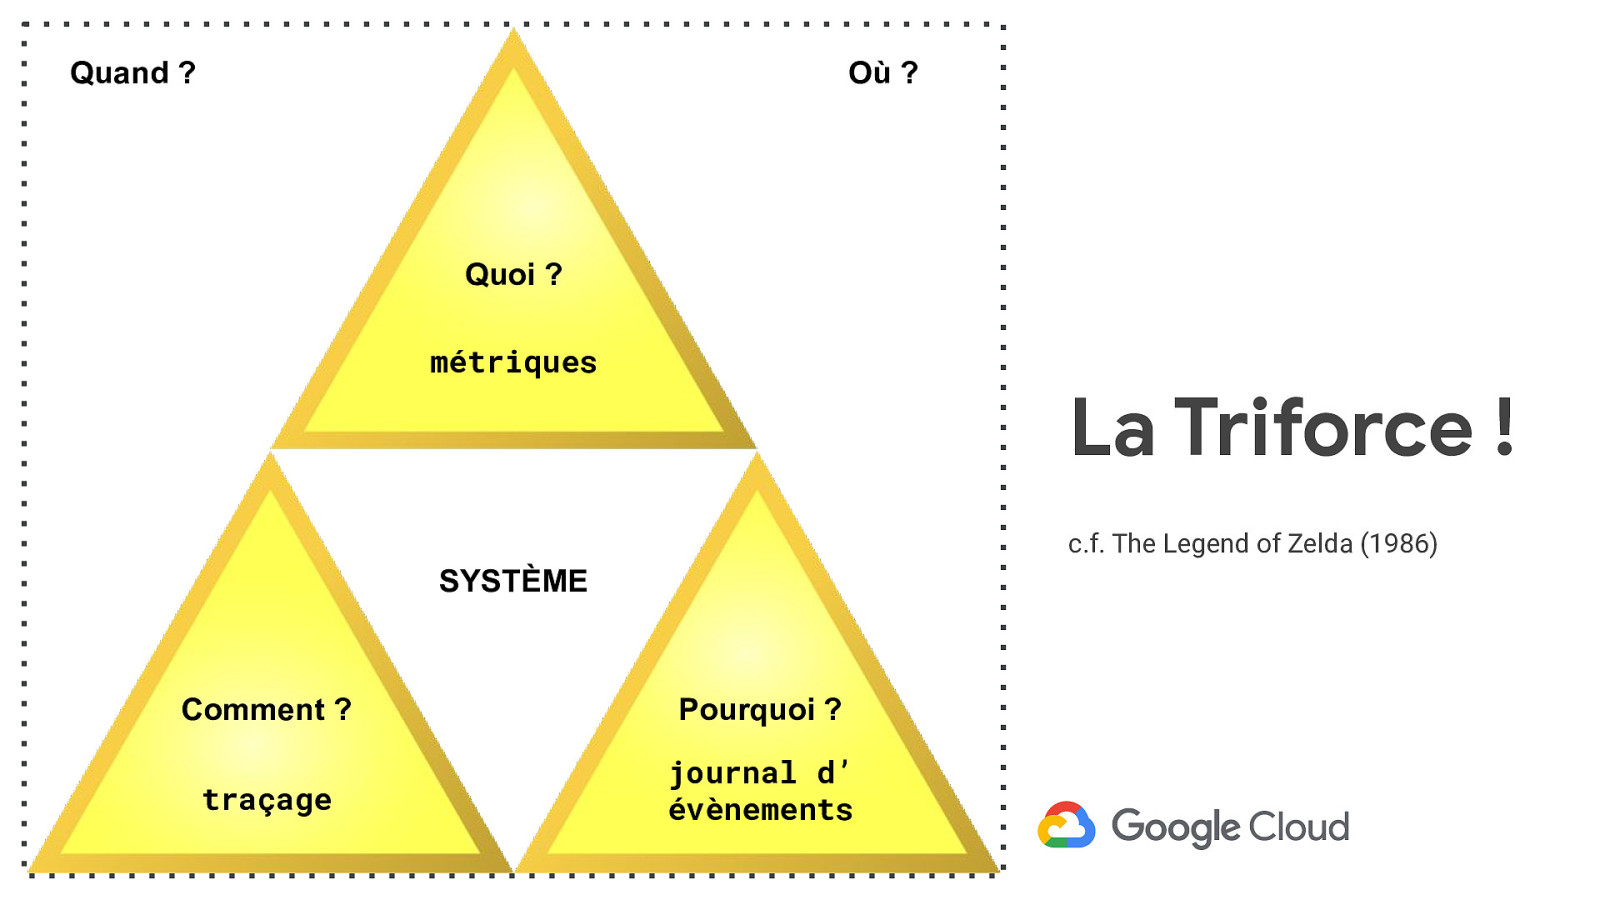
Quand ? Où ? Quoi ? métriques La Triforce ! c.f. The Legend of Zelda (1986) SYSTÈME Comment ? Pourquoi ? traçage journal d’ évènements
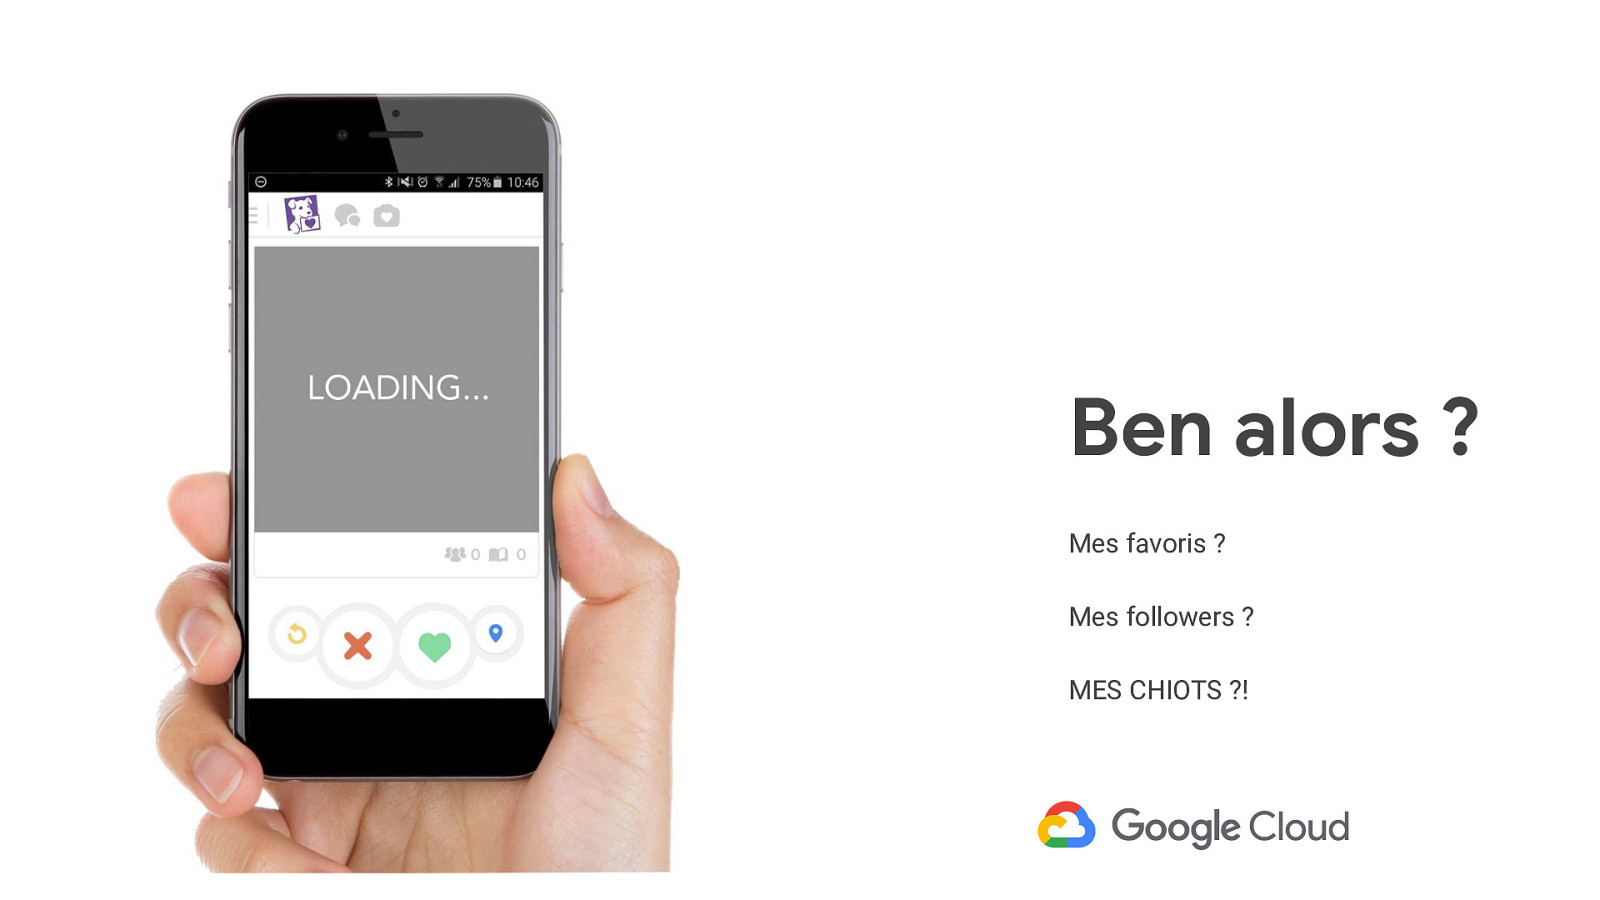
Ben alors ? Mes favoris ? Mes followers ? MES CHIOTS ?!
Les clés de la visibilité à 100 % ● Considérez l’ensemble. Les composants n’existent pas dans le vide. L’éco-système n’est pas fermé. Utilisez une approche holistique. ● Obtenez des multiples perspectives en exploitant toutes les sources de données. ● Préférez les outils « holistiques » qui vous permet de vous déplacer facilement entre les différentes couches et perspectives.
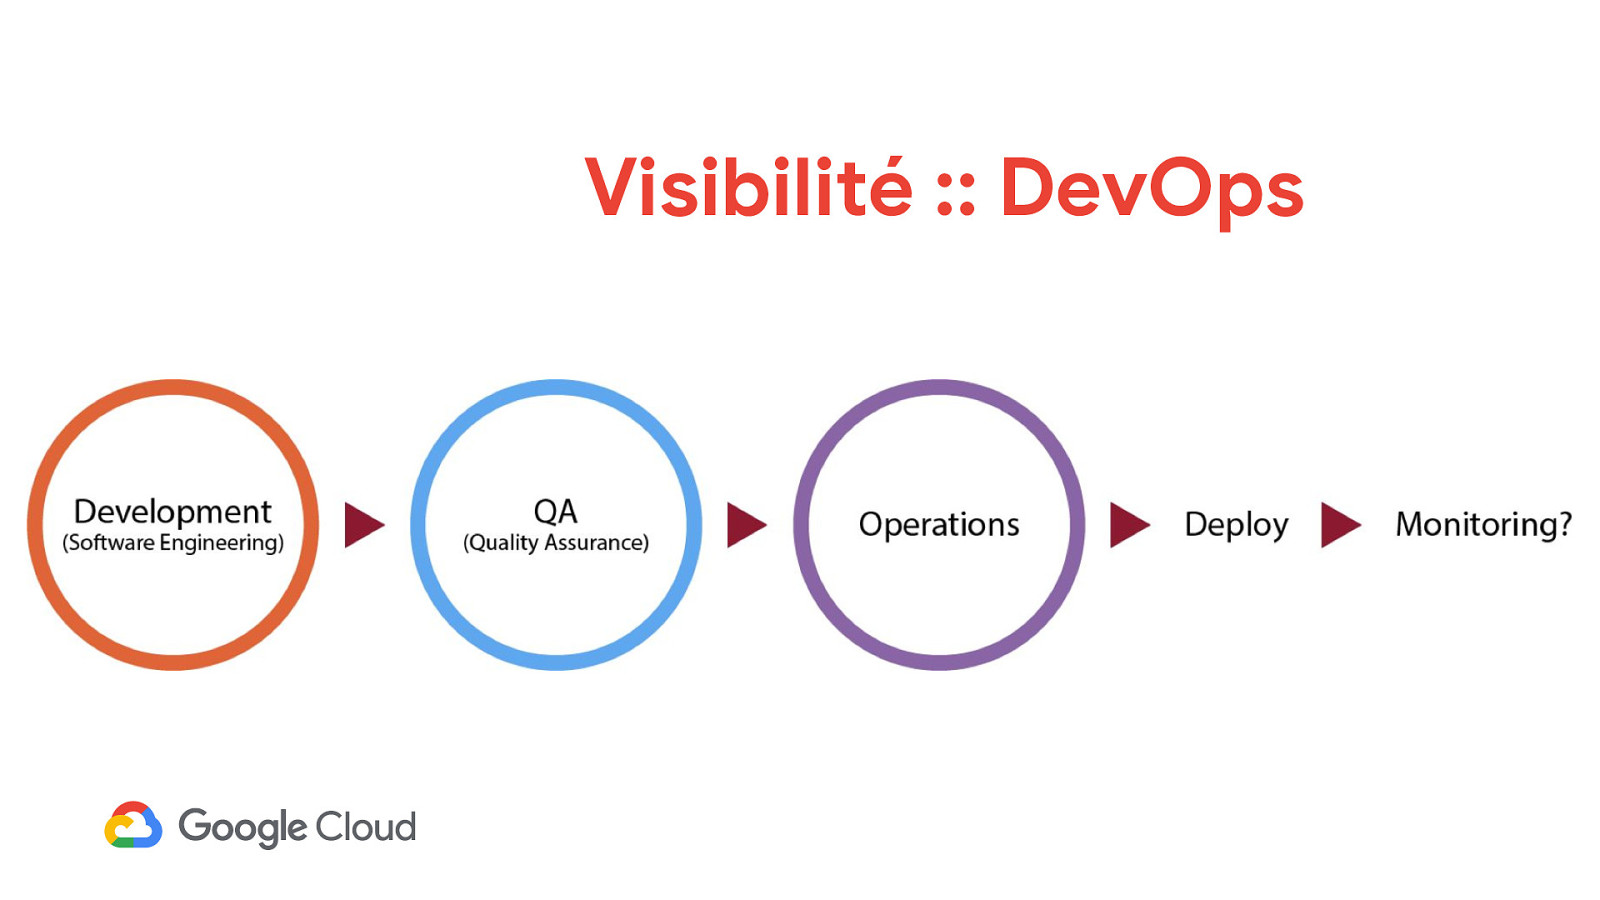
Visibilité :: DevOps
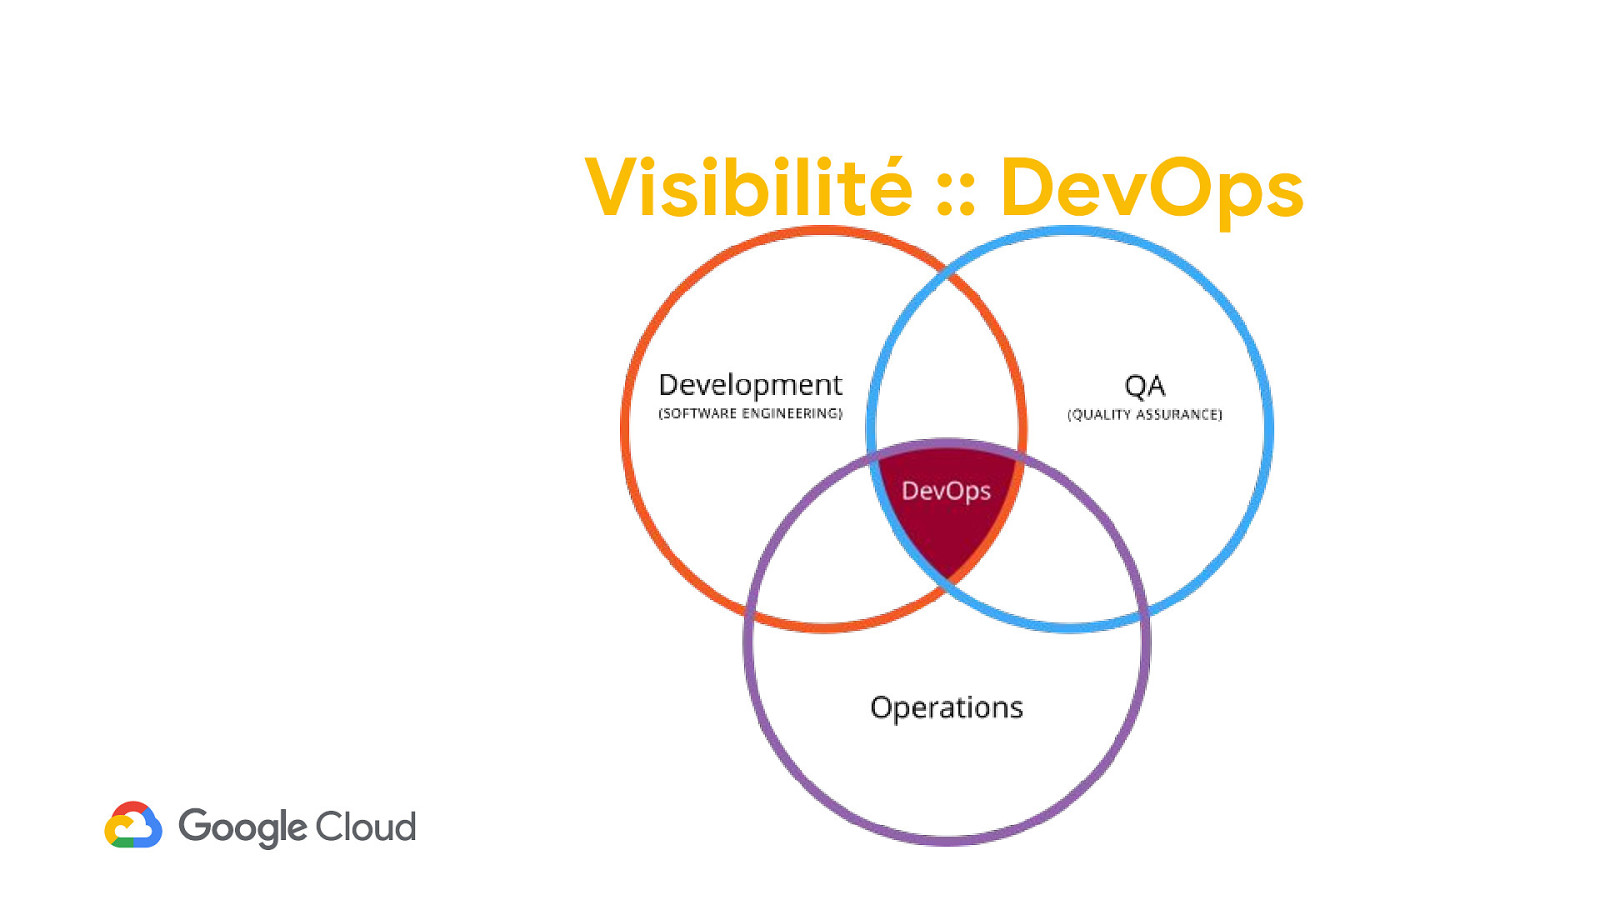
Visibilité :: DevOps
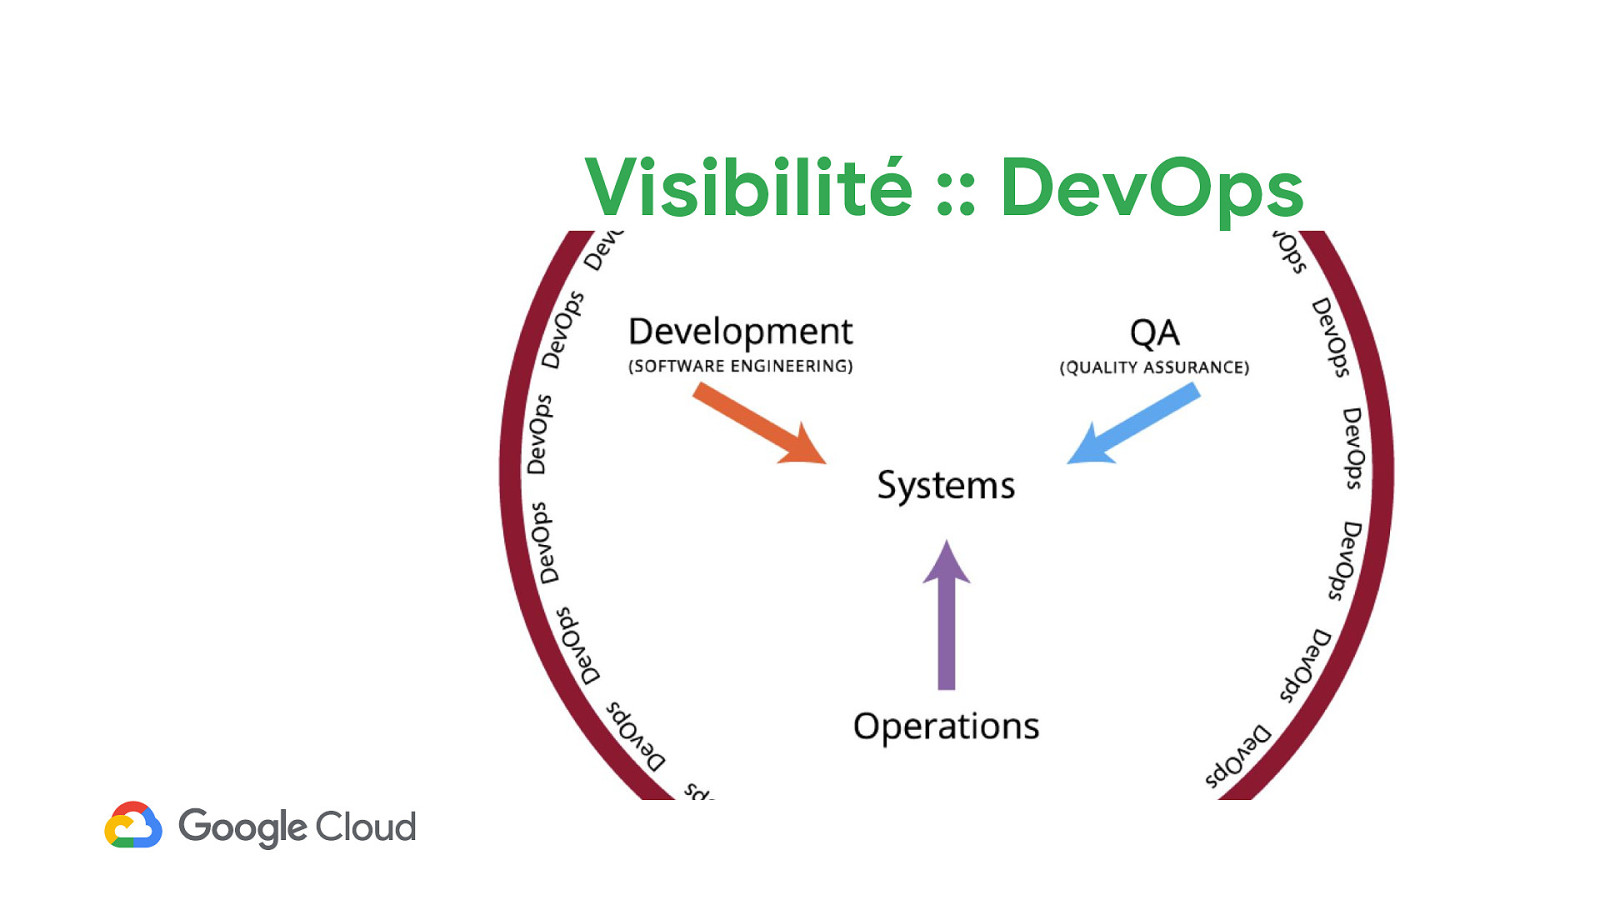
Visibilité :: DevOps
100 % visibilité 100 % devops Merci !
Come and join us at Next London ‘18! October 10th -11th, 2018 ExCeL, London Register at g.co/NextLondon18/Paris Thank you.